1 Détection et traitement des valeurs extrêmes
Frédéric Santos 
Dans cette section, nous donnerons quelques éléments théoriques sur les valeurs extrêmes (ou outliers), en reprenant sous forme condensée certains développements exposés dans Santos (2020).
1.1 Qu’est-ce qu’un outlier ?
1.1.1 Définition et sources possibles
Donner une définition précise du concept d’outlier n’est pas si évident : en première approche, une bonne partie des définitions trouvées dans la littérature scientifique sont plutôt de nature intuitive et informelle. On trouve par exemple la définition suivante chez Hawkins (1980) :
“An outlier is an observation which deviates so much from other observations as to arouse suspicions that it was generated by a different mechanism”.
Cette définition appelle davantage de précisions techniques (how much is “so much”?), et laisse la porte ouverte à de très nombreuses sources possibles pour expliquer la présence d’un outlier dans les données. Certaines sont relatives à des erreurs ou des problèmes évitables dans les données :
- erreur de saisie au moment de la saisie manuelle des données ;
- erreur de mesure au moment du protocole expérimental de collecte des données ;
- artefacts divers ou mauvaise calibration d’un appareil de mesure ;
- etc.
D’autres sont relatives à de réelles particularités d’un individu, et portent donc de l’information réelle : par exemple en neurosciences, un individu avec un temps de réaction extrêmement élevé pour être révélateur d’une pathologie ou d’une condition particulière ; en agronomie, une parcelle avec un rendement anormalement faible révèle des choix ou des événements ayant dégradé la productivité, etc.
Globalement, un outlier peut donc être défini comme une valeur ayant peu de chances d’avoir été générée par la même loi de probabilité que le reste de l’échantillon. Cela signifie en particulier que le fait d’être réellement détecté comme un outlier ou non dépend fortement :
- du modèle probabiliste sous-jacent pour la population (voir Section 1.1.2) ;
- du critère et du seuil statistiques utilisés pour moduler la “sévérité” de la déviation à partir de laquelle on considère qu’une valeur est “trop extrême” par rapport aux autres.
Concrètement, le lot de valeurs détectées comme étant des outliers va donc fortement varier d’une méthode à l’autre, ainsi qu’en fonction de choix méthodologiques plus ou moins arbitraires (ou en tout cas, ouverts !) que vous aurez à effectuer : voir Lightfoot et al. (2014) pour un exemple en archéologie. C’est d’ailleurs pour cela qu’il est parfois conseillé d’utiliser plusieurs méthodes statistiques de détection d’outliers et de comparer leurs résultats, comme nous le verrons plus loin.
NoteCas des données qualitatives
Notons que, dans ce qui suit, on ne s’intéressera qu’aux outliers pour des données numériques. Il est certes possible de définir également le concept d’outlier pour des données qualitatives (par exemple, un individu prenant des modalités très rares sur une ou plusieurs variables qualitatives), mais cette question ne sera pas traitée ici. De plus, les données qualitatives peuvent toujours se ramener à des données numériques : une idée classique serait de commencer par une analyse des correspondances multiples, puis de rechercher les valeurs extrêmes sur les coordonnées factorielles (numériques) des individus.
1.1.2 Hypothèses sur la distribution sous-jacente
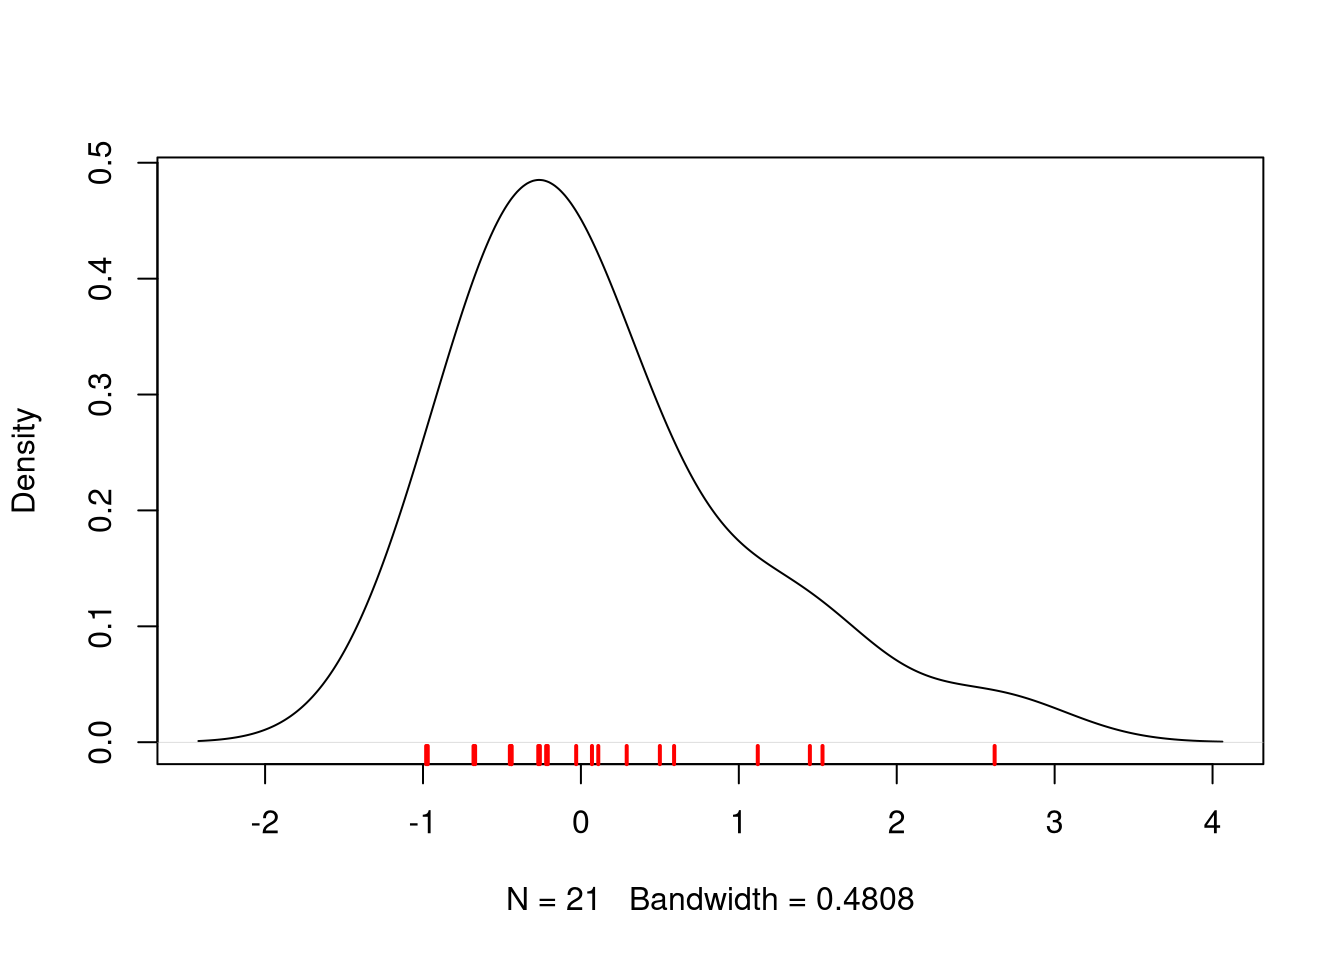
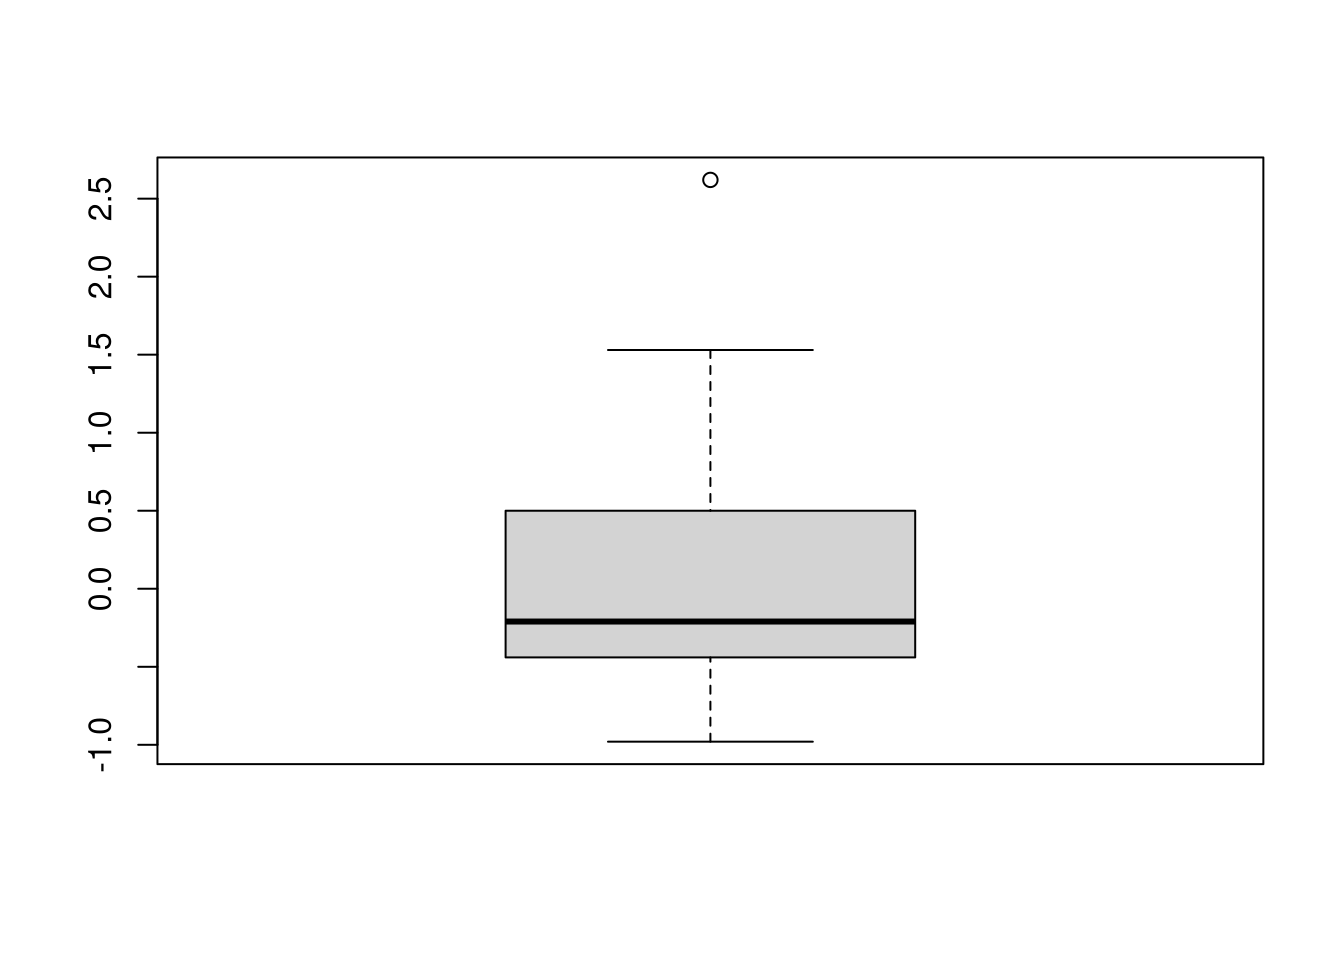
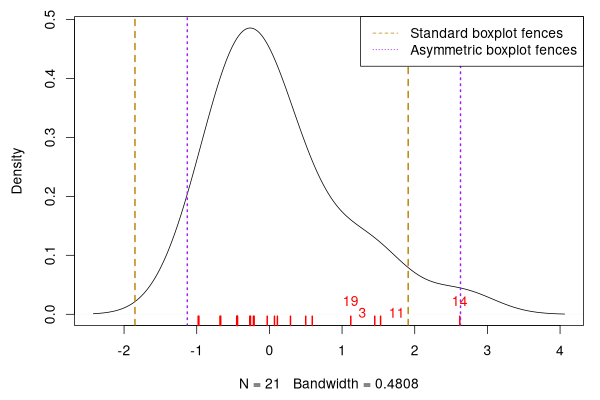
Il est important de noter qu’un outlier est toujours extrême relativement à une certaine norme, c’est-à-dire à un certain modèle probabiliste sous-jacent. Considérons par exemple l’échantillon représenté en Figure 1.1.
Ici, deux interprétations semblent raisonnables :
- La loi de probabilité sous-jacente est une distribution normale ; il y a donc un ou même plusieurs outliers sur la queue de distribution droite.
- La loi de probabilité sous-jacente est une distribution asymétrique, avec une queue de distribution étirée vers la droite. Toutes les valeurs observées sont donc parfaitement attendues, et aucune ne peut être considérée comme suspecte.
Trancher entre les deux modèles n’est pas évident, et seule l’expertise disciplinaire du praticien peut permettre de savoir quel modèle probabiliste adopter (et donc quels éventuels outliers détecter).
Nous reviendrons sur cet exemple en Section 1.3.2.
1.1.3 Typologie des outliers
Selon le contexte et la nature des données, on peut distinguer trois grands types d’outliers.
- Outliers univariés. Il s’agit d’observations prenant une valeur atypique sur une seule variable donnée.
- Outliers multivariés. Il s’agit d’observations dont la combinaison de plusieurs valeurs est atypique, ce qui peut se produire même si chacune des valeurs considérées isolément n’a rien d’atypique.
- Cellwise outliers. Dans ce concept issu de Rousseeuw et Bossche (2018), il s’agit de rechercher une valeur aberrante dans une cellule particulière d’une matrice de données, généralement de grande dimension. L’individu peut être relativement typique dans l’ensemble (et donc passer à travers les mailles des méthodes de détection d’outliers multivariés), mais contenir une ou quelques rares cellules légèrement improbables.
Ces trois catégories correspondent aussi à des niveaux différents d’analyse :
- niveau “variable” : outlier univarié (une valeur est atypique dans une variable) ;
- niveau “individu” : outlier multivarié (la ligne entière sera considérée comme atypique dans un tableau de données) ;
- niveau “cellule” : cellwise outlier (une ou quelques cellules sont aberrantes, sans que la ligne entière le soit nécessairement).
NoteQuelle différence entre outlier multivarié et cellwise outlier ?
Un outlier multivarié sera nécessairement aussi un cellwise outlier : si une ligne entière est globalement atypique, on pourra alors essayer d’identifier quelles variables contribuent à écarter cet individu de la norme.
En revanche, un cellwise outlier ne sera pas nécessairement détecté comme outlier multivarié, notamment si l’on travaille sur des données de très grande dimension et que l’anomalie est modérée et ne porte que sur une variable ou deux.
La différence est surtout une question de perspective : l’outlier multivarié peut être vu comme un row-wise outlier, tandis qu’avec un cellwise outlier, l’unité d’analyse n’est plus l’observation entière mais chaque cellule du tableau de données.
1.2 Que faire d’un outlier ?
Il existe beaucoup de méthodes statistiques de détection d’outliers, mais que faire lorsque ces méthodes en détectent dans nos données ?
Il n’y a pas réellement de réponse universelle à cette question. Comme nous l’avons vu plus haut, un outlier n’est pas nécessairement une erreur, et supprimer systématiquement les valeurs extrêmes est clairement une mauvaise pratique. Une démarche plus raisonnable pourrait consister à suivre les étapes suivantes.
Vérifier s’il s’agit d’une erreur. Retourner aux données brutes, et essayer d’identifier de potentielles erreurs de saisie ou de mesure. En cas d’erreur évidente et d’impossibilité de procéder à une nouvelle acquisition de donnée pour cette valeur, écarter l’individu, ou au moins remplacer la valeur fautive par une valeur manquante, est justifié.
Déterminer si la valeur est plausible. Une valeur peut être rare et atypique tout en restant plausible. Si vous disposez d’une plage de valeurs théoriques admissibles pour le phénomène étudié, cela vous évitera d’écarter à tort des valeurs au seul motif qu’elles sont inhabituelles. De plus, dans un certain nombre de situations, les outliers correspondent précisément à un signal très intéressant dans les données, que l’on souhaitera étudier pour lui-même (Santos 2020).
Choisir une méthode adaptée. De forts outliers sont généralement une contre-indication pour les méthodes statistiques classiques. Toutefois, l’idéal reste d’utiliser des statistiques robustes (médiane plutôt que moyenne, IQR plutôt qu’écart-type) et des modèles robustes (régression linéaire robuste, analyse discriminante robuste, etc.), permettant de modérer l’influence des outliers plutôt que des les écarter de l’analyse.
Évaluer l’influence des outliers. Si la méthode statistique employée et le contexte s’y prêtent, il peut être pertinent d’effectuer une analyse de sensibilité. Dans l’approche la plus élémentaire, il s’agit simplement d’analyser d’abord les données avec les outliers, puis de refaire l’analyse sans eux, et de comparer les résultats.
1.3 Quelques règles et algorithmes de détection d’outliers
Nous allons voir ci-dessous quelques exemples pratiques de détection d’outliers avec R. Commençons par charger les packages nécessaires, ainsi que les données penguins contenues dans le package {palmerpenguins}.
library(aplpack)
library(car)
library(cellWise)
library(dplyr)
library(palmerpenguins)
library(robustbase)
library(univOutl)
data(penguins)
1.3.1 La règle classique des boxplots
La Figure 1.4 présente des boxplots par espèce pour la variable bill_length_mm. Un outlier est identifié pour l’espèce Gentoo.
car::Boxplot(bill_length_mm ~ species, data = penguins)[1] "186"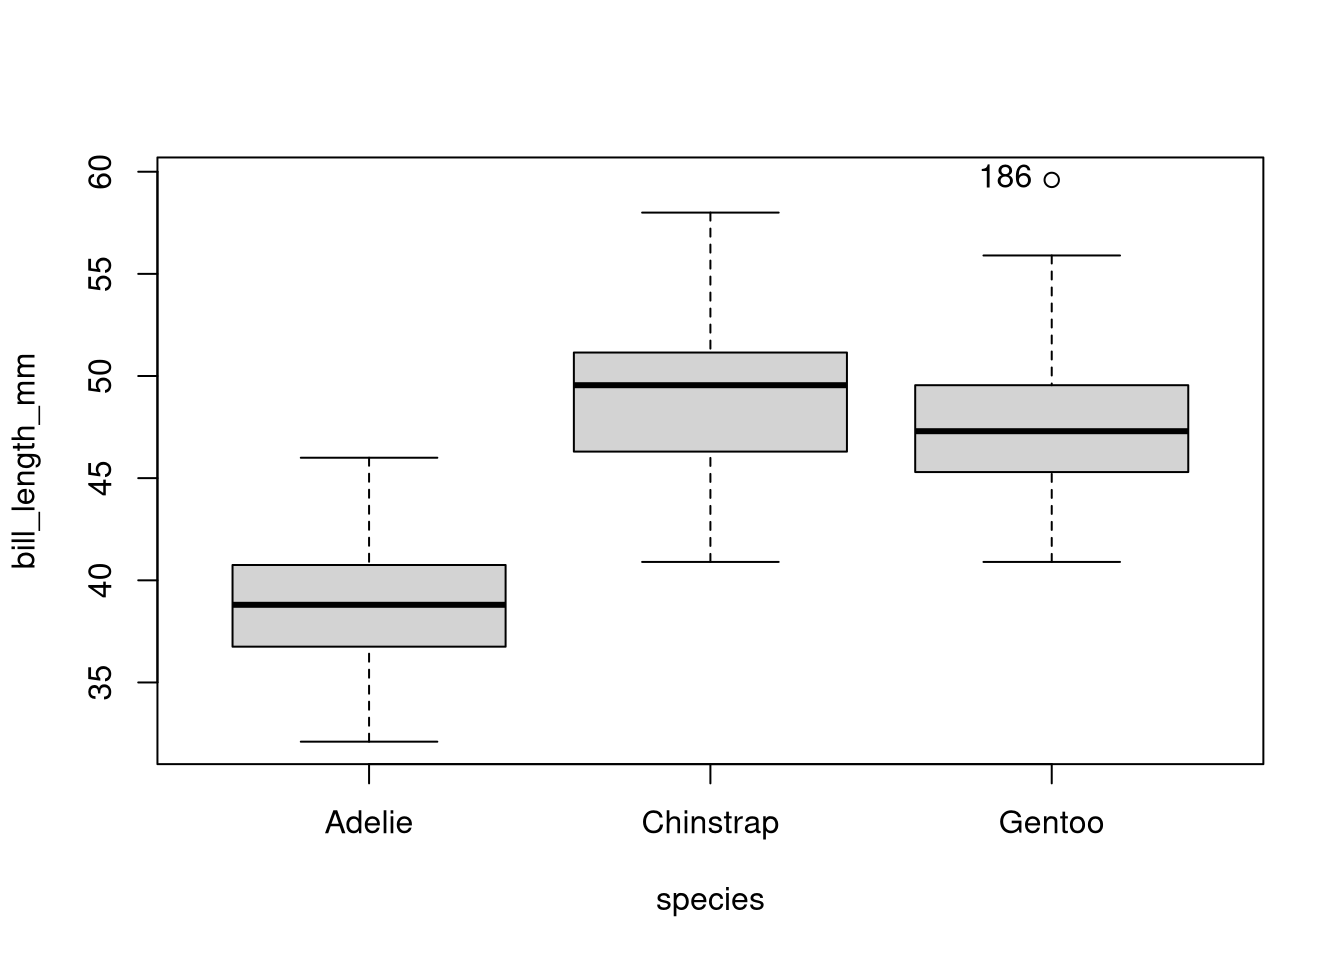
Astuce
boxplot() ou Boxplot() ?
Notez que le code ci-dessus utilise la fonction Boxplot() du package {car} plutôt que la fonction de base boxplot(). La seule différence entre les deux consiste en l’identification automatique (et par défaut) d’éventuels outliers, en affichant leur numéro de ligne dans le dataframe d’origine.
L’identification d’outliers univariés par “la règle des boxplots” (Tukey 1977) consiste en un critère simple : tout individu en dehors de l’intervalle \([q_1 - 1.5 \times IQR \; ; \, q_3 + 1.5 \times IQR]\) (où \(q_1\) et \(q_3\) sont respectivement les premier et troisième quartile, et où \(IQR := q_3 - q_1\)) sera considéré comme un outlier. Le coefficient \(1.5\) peut éventuellement être fixé à une valeur supérieure pour obtenir une règle plus conservatrice.
Cet intervalle est centré sur la moyenne arithmétique de \(q_1\) et \(q_3\). La règle classique des boxplots ne fait aucune hypothèse sur la distribution des valeurs, mais on peut prouver que pour une distribution normale, il contiendra environ \(99.3 \%\) des valeurs (ce qui signifie qu’environ \(0.7 \%\) des valeurs seront reconnues comme extrêmes).
1.3.2 La règle des boxplots pour distributions asymétriques
Si notre connaissance à priori du phénomène nous indique que nous avons de grandes chances d’être en présence de distributions asymétriques (par exemple, des temps de réaction en neurosciences, ou des salaires en économie), Kimber (1990) a proposé d’adapter la règle classique des boxplots pour détecter de façon plus efficace les outliers (notamment éviter trop de faux positifs). L’intervalle suivant remplace alors celui des boxplot classiques :
\[ [q_1 − 2k \times (m − q_1) \; ; \, q_3 + 2k \times (q_3 − m)] \]
où \(m\) est la médiane, et où généralement, on a là encore \(k = 1.5\), mais cette valeur peut être adaptée en fonction du contexte.
Cet intervalle peut produire des résultats sensiblement différents de la règle classique dans le cas de distributions asymétriques. Pour reprendre l’exemple développé en Section 1.1.2 et en Figure 1.1, comparons ci-dessous les résultats obtenus avec ces deux critères :
En R, la fonction boxB() du package {univOutl} implémente cette règle de décision.
1.3.3 Méthodes robustes de détection d’outliers univariés
Dans le cas où l’on peut raisonnablement supposer être en présence de données issues d’une loi normale \(\mathcal{N}(\mu, \sigma^2)\), il existe la règle bien connue “des deux écarts-types” : l’intervalle de fluctuation \[[\hat{\mu} - 2 \hat{\sigma}^2 ; \hat{\mu} + 2 \hat{\sigma}^2] \tag{1.1}\] contient environ 95% des valeurs issues d’une telle loi. Toute valeur située en dehors de cet intervalle est alors souvent considérée comme “extrême”.
Cette règle basique est en réalité assez peu pertinente, car peu robuste (en particulier sur les petits échantillons). En effet, l’estimateur empirique de la variance \(\hat{sigma}\) est lui-même très sensible à la présence d’outliers : cet estimateur va connaître une “inflation” importante s’il existe des outliers dans les données… et donc donner lieu à un intervalle trop large, qui ne détectera sans doute pas lesdits outliers.
Pour contourner ce problème, Leys et al. (2013) suggère de remplacer l’intervalle précédent par un intervalle utilisant des estimateurs robustes de tendance centrale et de dispersion, de la forme générale :
\[ [m - k \times s \; ; \, m + k \times s] \tag{1.2}\]
où \(m\) sera un estimateur robuste de tendance centrale (généralement la médiane), \(s\) sera un estimateur robuste de dispersion, et \(k\) sera comme toujours une constante généralement fixée à \(k := 2\) ou \(k := 3\) selon la sévérité souhaitée. Ainsi, les estimateurs de tendance centrale et de dispersion sont calculés sans influence néfaste des outliers, et sont donc plus aptes à détecter leur présence.
Les choix classiques pour l’estimateur robuste de dispersion \(s\) d’un échantillon \(x := (x_1, \ldots, x_n)\) incluent :
- l’intervalle inter-quartiles (IQR), défini par \(m := q_3 - q_1\) ;
- la déviation absolue à la médiane (MAD), définie par \(m := b \times \text{med} \left( |x_i - \text{med}(x)|_{1 \leq i \leq n}\right)\) (Rousseeuw et Croux 1993), où le choix du facteur d’échelle \(b\) dépend du type de distribution pré-supposé (par exemple, on choisit usuellement \(b \approx 1.48\) pour une loi normale) ;
- l’estimateur \(S_n\) (Rousseeuw et Croux 1993), défini par \(c \times \text{med}_i \{ \text{med}_j |x_i - x_j|\}\). Il s’agit donc de calculer tout d’abord, pour chaque observation \(x_i\), la médiane de ses distances absolues aux autres observations ; puis on prend la médiane globale de toutes ces \(n\) médianes. Cet estimateur est plus adapté que la MAD dans le cas de distributions supposément asymétriques.
En R, la fonction LocScaleB() du package {univOutl} implémente ces règles robustes.
## Utilisation de la MAD pour détecter des outliers sur la longueur des becs :
out.bills <- LocScaleB(
  x = penguins$bill_length_mm,
  k = 2,
  method = 'MAD', # essayer d'autres méthodes ici !
  return.dataframe = TRUE
)
No. of outliers in left tail: 0No. of outliers in right tail: 1subset(out.bills$data, outliers == 1) id x score outliers
185 186 59.6 2.151271 1Le “score” affiché est un score standardisé défini comme \((x - m) / s\), c’est-à-dire comme l’écart entre l’observation et la tendance centrale (robuste), normalisée par la dispersion (robuste).
1.3.4 Détection robuste d’outliers multivariés avec le MCD
La même logique peut être appliquée au cas multivarié. Rappelons que lorsqu’on travaille en dimension \(p\), où chaque individu \(\mathbf{x}_i\) du jeu de données est donc un vecteur \(\mathbf{x}_i := (x_{i1}, x_{i2}, \ldots, x_{ip})\), la distance de Mahalanobis entre un individu \(\mathbf{x}_i\) et la moyenne empirique \(\hat{mu}\) est définie par :
\[ d(\mathbf{x}_i, \hat{\mu}) := \sqrt{{}^t(\mathbf{x}_i - \hat{\mu}) \Sigma^{-1} (\mathbf{x}_i - \hat{\mu})} \tag{1.3}\]
où \(\Sigma\) est la matrice de covariance empirique de l’échantillon de données.
Alors, une règle classique (non-robuste) généralisant le cas univarié de l’Équation 1.1 consiste à dire qu’un point \(\mathbf{x}_i\) est un outlier si \(d(\mathbf{x}_i, \hat{\mu}) \geq \sqrt{\chi^2_{p, \, 1 - \alpha}}\). (En d’autres termes, si sa distance à la moyenne empirique est supérieure à un certain seuil, défini comme le quantile d’ordre \(1 - \alpha\) d’une loi de Pearson à \(p\) degrés de liberté.)
Malheureusement, on retombe ici sur le même problème de robustesse que dans le cas univarié : comme pour l’intervalle présenté en Équation 1.1, ce critère multivarié repose sur des estimateurs de tendance centrale (\(\hat{\mu}\)) et de dispersion (\(\Sigma\)) qui sont non-robustes, seront sensiblement distordus par la présence d’outliers, et ne seront donc pas efficaces pour détecter lesdits outliers (notamment dans le cas de petits échantillons).
Par conséquent, la même solution que dans le cas univarié s’applique ici : il suffit de remplacer dans l’Équation 1.3 ces estimateurs non-robustes \(\hat{\mu}, \Sigma\) par des estimateurs robustes \(\hat{\mu}_\text{MCD}, \Sigma_\text{MCD}\) afin d’améliorer cette règle de décision. C’est le but de l’algorithme MCD, Mininum Covariance Determinant (Hubert et al. 2018; Rousseeuw et Van Driessen 1999). Il procède comme suit :
- Votre connaissance à priori du phénomène étudié peut vous conduire à avoir une idée vague de la proportion d’outliers dans les données. Insistons : une idée vague suffit, mais vous savez sans doute à priori si la proportion d’outliers est plutôt de l’ordre de 2% ou de 20%. Vous pouvez indiquer à l’algorithme que le nombre de points “non-outliers” dans vos données est à peu près égal à \(h\), avec \(h \in [n/2, n[\).
- L’algorithme tire alors au sort des sous-ensembles de données incluant \(h\) individus, et calcule pour chacun d’eux la variance généralisée définie comme étant le déterminant de la matrice de covariance, \(|\Sigma|\) (Gupta 2014).
- L’algorithme retient alors le sous-ensemble de données donnant la variance généralisée la plus faible : on peut considérer qu’il s’agit de la “bonne portion” des données, non contaminée par des outliers.
- En utilisant ce sous-ensemble optimal, on calcule alors les estimateurs robustes définitifs \(\hat{\mu}_\text{MCD}, \Sigma_\text{MCD}\).
La même règle de décision que précédemment s’applique, en substituant ces deux estimateurs robustes dans l’Équation 1.3.
AvertissementConditions d’application
Attention : il est conseillé de n’appliquer l’algorithme MCD que dans le cas où le nombre d’individus est très supérieur au nombre de variables. Si vous travaillez avec des données de grande dimension (une centaine de variables par exemple), assurez-vous donc d’avoir un très large échantillon de données — ou optez plutôt pour une autre méthode.
En R, le package {robustbase} implémente l’algorithme MCD. Commençons par calculer les estimateurs robustes MCD pour le sous-ensemble de données constitué des femelles Chinstrap uniquement. Le paramètre alpha de la fonction covMcd() représente la “bonne portion” de vos données, et Leys et al. (2018) a prouvé que fixer alpha à une valeur d’environ trois quarts de l’effectif total donne généralement de bons résultats (mais bien entendu, ça reste à adapter dans votre cas !). Choisissons ici une valeur légèrement supérieure, alpha=0.8, i.e. 80% de l’effectif total.
## Sélectionner les femelles Chinstrap uniquement :
chinstrapf <- penguins |>
  subset(species == "Chinstrap" & sex == "female") |>
  dplyr::select(bill_length_mm:body_mass_g)

## Estimation MCD pour les femelles Chinstrap :
mcd <- covMcd(chinstrapf, alpha = 0.8)

print(mcd)
Minimum Covariance Determinant (MCD) estimator approximation.
Method: Fast MCD(alpha=0.8 ==> h=28); nsamp = 500; (n,k)mini = (300,5)
Call:
covMcd(x = chinstrapf, alpha = 0.8)
Log(Det.): 14.2
Robust Estimate of Location:
bill_length_mm bill_depth_mm flipper_length_mm body_mass_g
46.31 17.57 191.75 3525.78
Robust Estimate of Covariance:
bill_length_mm bill_depth_mm flipper_length_mm
bill_length_mm 6.6579 0.7348 8.5260
bill_depth_mm 0.7348 0.7464 0.6452
flipper_length_mm 8.5260 0.6452 32.8533
body_mass_g 214.3636 109.4806 613.4092
body_mass_g
bill_length_mm 214.4
bill_depth_mm 109.5
flipper_length_mm 613.4
body_mass_g 99486.9On calcule ensuite les distances de Mahalanobis robustes entre chaque point et la moyenne empirique globale :
## Calcul des distances de Mahalanobis (au carré) robustes :
d2 <- mahalanobis(
  x = chinstrapf,
  center = mcd$center,
  cov = mcd$cov
)
Enfin, on peut comparer ces distances au seuil théorique de \(\chi^2_{p, 0.99}\) pour détecter d’éventuels outliers :
## Seuil basé sur la loi du Khi² à 4 degrés de libertés (car 4 variables) :
seuil <- qchisq(0.99, df = 4)

## Qui sont les individus dépassant ce seuil ?
(outliers <- which(d2 > seuil))
[1] 9 33Très éventuellement, on peut aussi représenter graphiquement la distance de Mahalanobis robuste obtenue pour chaque individu de l’échantillon, comme en Figure 1.6.
plot(
  sqrt(d2),
  pch = 16,
  col = ifelse(d2 > seuil, yes = "red", no = "black"),
  ylab = "Distance de Mahalanobis robuste",
  xlab = "Numéro d'individu",
  main = "Détection d'outliers multivariés avec l'algorithme MCD"
)

abline(h = sqrt(seuil), col = "blue", lty = 2)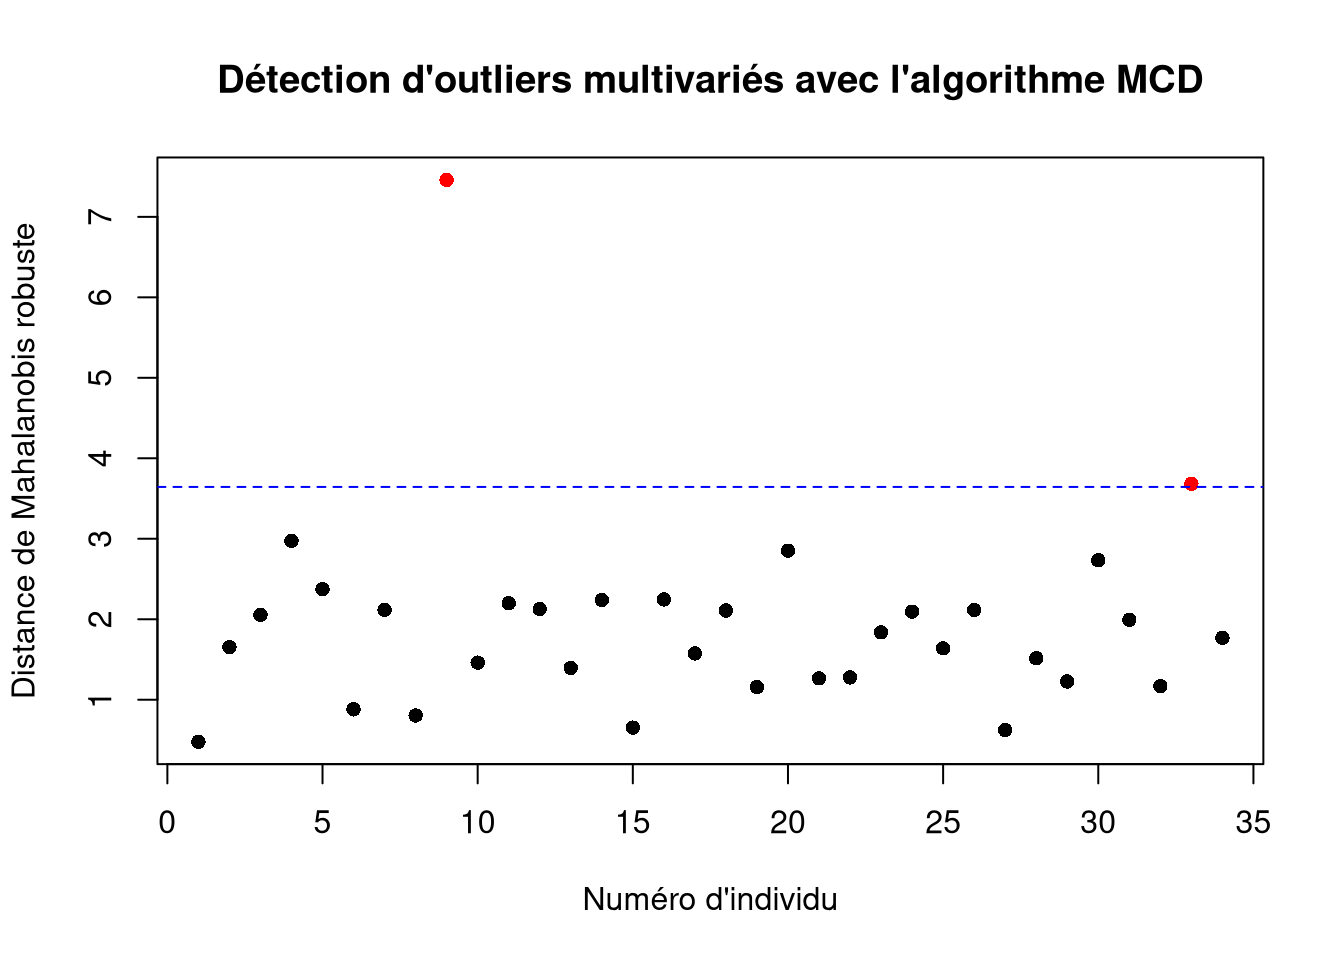
Certains auteurs suggèrent également d’effectuer des “graphiques distance-distance” : des nuages de points croisant la distance de Mahalanobis classique et la distance de Mahalanobis robuste entre chaque point et la moyenne (e.g., Willems et al. 2009). Tout individu connaissant une très forte augmentation entre la distance classique et la distance robuste est un clair candidat outlier.
NoteStandardiser les variables ?
Une question légitime : si vos variables sont d’un ordre de grandeur substantiellement différent, devriez-vous standardiser vos données avant d’appliquer l’algorithme MCD ? La réponse sera généralement non : avec ou sans standardisation, les individus détectés comme outliers devraient être identiques dans la grande majorité des cas. Tout au plus, dans des cas très spécifiques, la standardisation des variables peut amener un petit surplus de stabilité de la méthode.
1.3.5 Le bagplot, équivalent bivarié des boxplots
La méthode MCD suppose des distributions proches d’une loi normale multivariée : elle peut parfois ne pas être adaptée pour détecter des outliers dans le cas de distributions bivariées assez éloignées d’une loi gaussienne. Dans ce cas, le bagplot peut être une alternative intéressante (Rousseeuw et al. 1999).
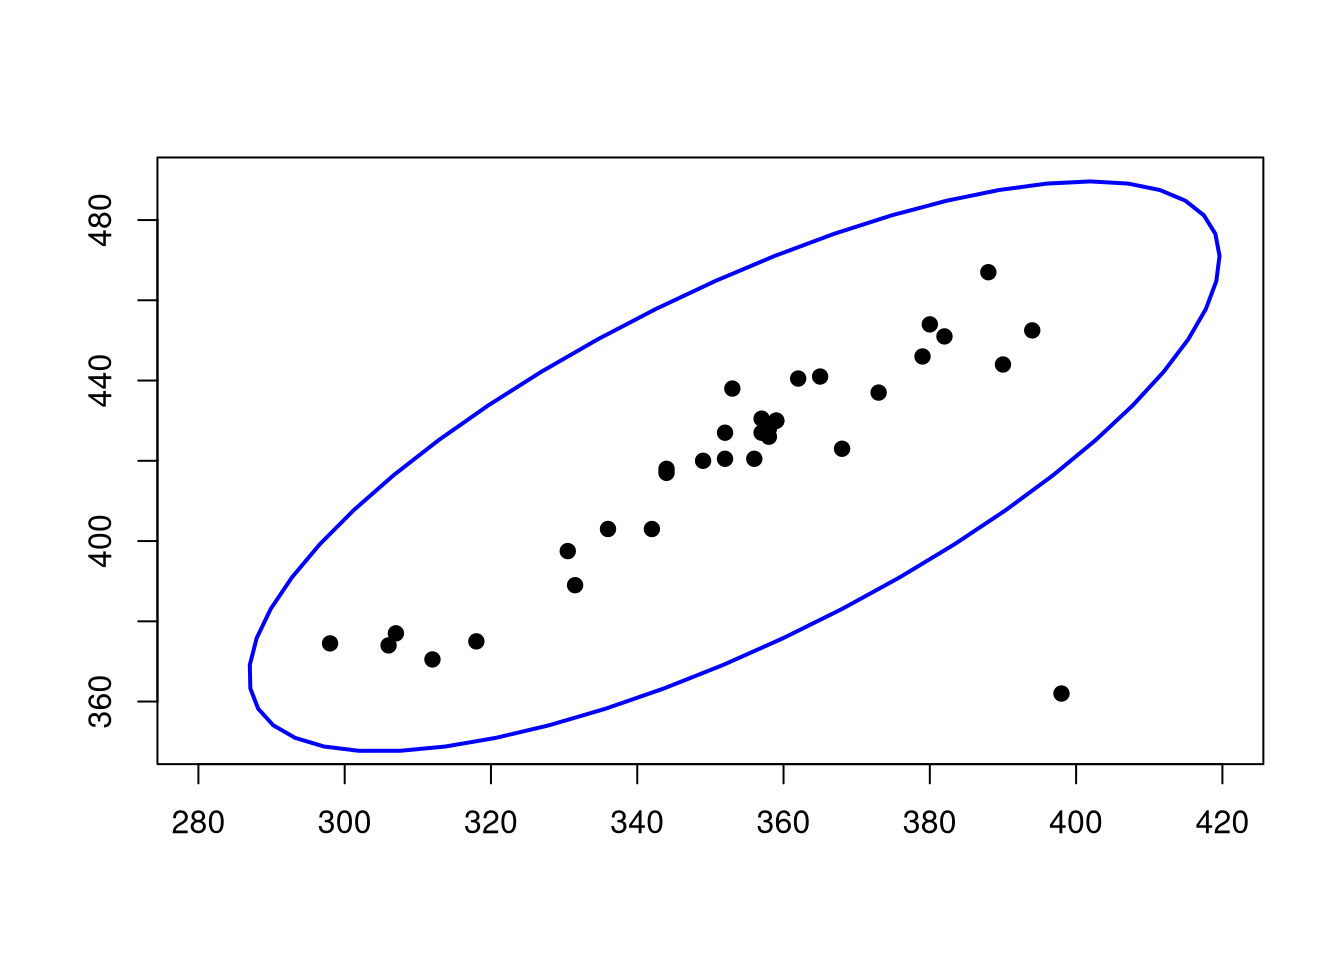
Il s’agit d’une généralisation bivariée des boxplots : un polygone central contiendra environ 50% des individus “les plus centraux”, et tout point situé en-dehors d’une zone construire comme le “gonflement” de ce polygone central par un facteur 3, sera considéré comme un outlier. La représentation graphique du bagplot s’accompagne alors également de l’enveloppe convexe des points “non-aberrants” (Figure 1.7).
## Afficher un bagplot :
bagplot(
  x = chinstrapf$bill_depth_mm,
  y = chinstrapf$bill_length_mm,
  xlab = "Bill depth (mm)",
  ylab = "Bill length (mm)",
  show.center = FALSE,
  show.whiskers = FALSE,
  cex = 1
)
text(
  x = chinstrapf$bill_depth_mm,
  y = chinstrapf$bill_length_mm,
  labels = 1:nrow(chinstrapf),
  cex = 0.7,
  pos = 1
)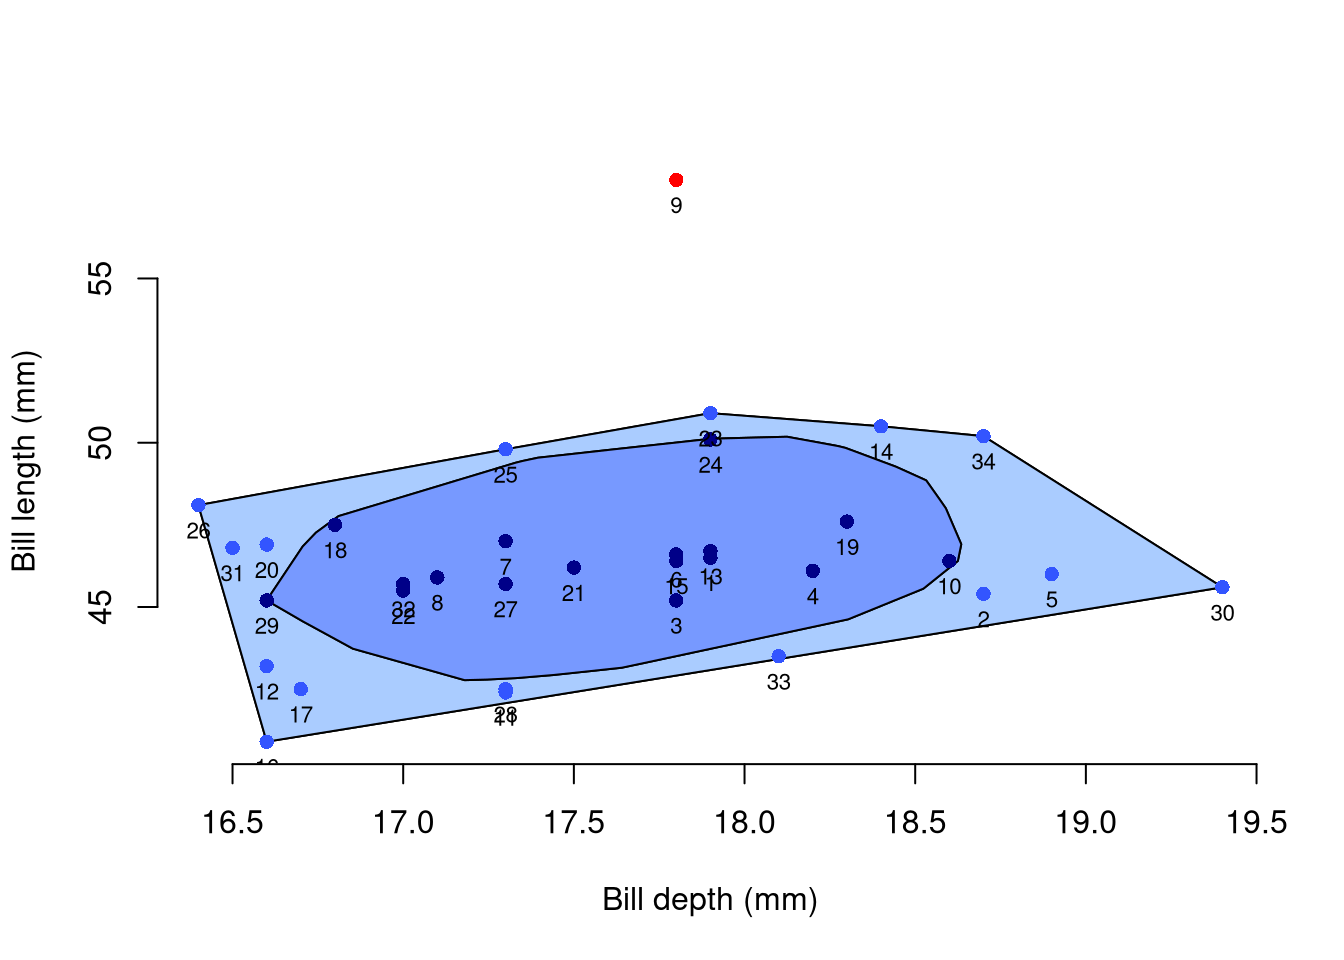
Cette méthode ne fait aucune supposition sur la distribution des données, et peut donc être utilisée pour toute détection d’outliers bivariés.
1.3.6 Autres méthodes de détection d’outliers multivariés
Il existe encore de nombreux autres algorithmes, qui ne peuvent pas tous être évoqués dans le détail ici. Nous verrons d’ailleurs plus tard, en Section 2.5, un moyen pratique de comparer les résultats de plusieurs algorithmes de détection d’outliers multivariés.
Toutefois, les isolation forests (Liu et al. 2012) constituent un dernier algorithme remarquable de détection d’outliers multivariés, particulièrement intéressant car sa logique diffère de celle de tous les algorithmes évoqués jusqu’ici.
La logique commune des méthodes ci-dessus était de considérer qu’un outlier est un point situé “trop loin” du reste des données — ce qui fait évidemment sens. Dans le cas des isolation forests en revanche, l’idée est plutôt qu’un outlier est un point qui aura peu de voisins autour de lui. On cherche donc en réalité un point “isolé”, d’où le nom de la méthode. Les isolation forests reposent essentiellement sur la base théorique des forêts aléatoires (Breiman 2001) et des arbres de décision. Une autre idée forte dans la logique des isolations forests est que fournir une série d’instructions pour localiser un point situé en plein milieu des données sera extrêmement long et fastidieux car il s’agit d’une zone très dense en points, alors que localiser un outlier peut se faire à partir d’instructions extrêmement brèves (“c’est le seul point avec \(X_5 > 30\)”). Ainsi, plus un point est localisable à l’aide d’un chemin très court, plus il est susceptible d’être un outlier.
Actuellement, l’implémentation R la plus stable est celle fournie par le package {isotree} (Cortes 2019), mais (en date du mois de juillet 2026) l’écosystème reste encore perfectible par rapport à celui offert par scikit-learn en Python. Pour plus de détails sur cette méthode, on pourra par exemple consulter la vignette du package {isotree}.
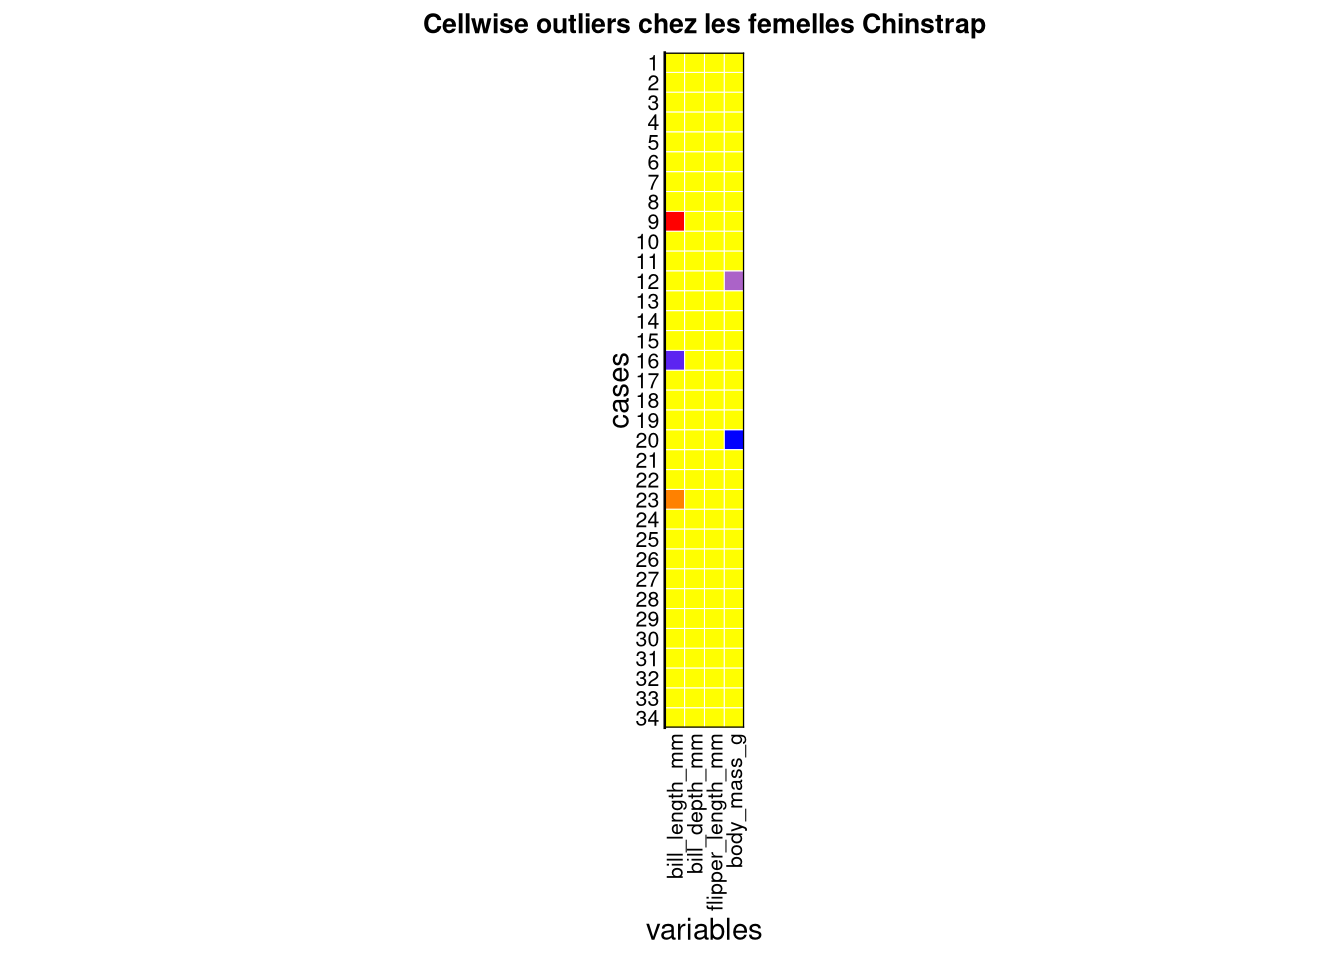
1.3.7 Détection de cellwise outliers avec l’algorithme DDC
Pour terminer, décrivons rapidement l’algorithme DDC (Detecting Deviating Cells) introduit par Rousseeuw et Bossche (2018). Comme son nom l’indique, cet algorithme vise à détecter les cellules d’un dataframe qui semblent douteuses ou inhabituelles, plutôt que des lignes entières. Il peut donc s’avérer précieux pour savoir pourquoi un outlier multivarié diffère du reste des données, ou pour repérer plus facilement des erreurs de saisie grossières dans un dataframe.
Schématiquement, l’algorithme DDC procède ainsi :
- Les variables sont tout d’abord standardisées, à l’aide d’estimateurs robustes de tendance centrale et de dispersion.
- L’algorithme DDC exploite ensuite l’intercorrélation existant entre les différentes variables. Grâce à cette intercorrélation, pour chaque individu \(i\), la \(j\)-ième variable peut être prédite à l’aide de toutes les autres variables connues pour cet individu (là encore à l’aide de modèles robustes). Ainsi, pour chaque cellule \(x_{ij}\) du jeu de données, une valeur prédite \(\hat{x}_{ij}\) est calculée.
- Pour chaque cellule du jeu de données, calculer le résidu, i.e. l’écart \(r_{ij} := x_{ij} - \hat{x}_{ij}\) entre la vraie valeur et la valeur prédite. Ces résidus peuvent être renormalisés par un estimateur robuste de dispersion.
- Intuitivement, les outliers sont alors les cellules qui ont un résidu “trop élevé”, i.e. dépassant un certain seuil : la valeur réellement observée \(x_{ij}\) est trop éloignée de la valeur théorique à laquelle on aurait pu s’entendre en connaissant le reste du profil de l’individu. Le seuil à ne pas dépasser est généralement déterminé comme étant un quantile (d’ordre 99%, ou 99.9% par exemple) de la distribution des résidus.
En R, l’algorithme DDC est implémenté dans le package {cellWise} (Raymaekers et al. 2020). Illustrons ci-dessous son fonctionnement à l’aide du jeu de données {penguins}.
L’utilisation se fait en deux étapes. La première est de faire tourner l’algorithme DDC, par exemple sur la portion de données constituée des femmes Chinstrap uniquement, et de stocker les résultats dans un objet R :
## Exécuter l'algorithme DDC sur les femelles Chsintrap :
ddc.res <- DDC(
  X = chinstrapf,
  DDCpars = list(tolProb = 0.99)
)
The input data has 34 rows and 4 columns.On peut ensuite représenter visuellement les cellules détectées comme étant inhabituelles :
## Carte des cellwise outliers :
cellMap(
  R = ddc.res$stdResid,
  mTitle = "Cellwise outliers chez les femelles Chinstrap",
  sizemain = 1,
  sizetitles = 1.1,
  sizerowlabels = 0.8,
  sizecolumnlabels = 0.8
)