library(bioanth)
library(MASS)
library(psych)
library(rogme)
library(rrcov)
library(tidyverse)
library(WRS2)3 Pratique : méthodes graphiques et statistiques robustes avec R
Frédéric Santos 
Une fois de plus, commençons par charger les packages dont nous aurons besoin pour les analyses ci-dessous :
3.1 Exemple 1 : salaires des joueurs américains de baseball
Dans ce premier exemple, nous utiliserons les données de la Lahman Baseball Database sur les salaires des joueurs professionnels de baseball aux États-Unis sur les dernières décennies.
3.1.1 Importer et résumer le jeu de données
Après téléchargement du fichier Salaries.csv, on peut l’importer et le résumer avec le code suivant :
## Importer et résumer la feuille CSV :
salaries <- read.csv(
  file = "./data/Salaries.csv",  # adapter dans votre cas
  stringsAsFactors = TRUE
)
summary(salaries)
yearID teamID lgID playerID salary
Min. :1985 LAN : 957 AL:12959 moyerja01: 25 Min. : 10900
1st Qu.:1994 CLE : 949 NL:13469 vizquom01: 24 1st Qu.: 295000
Median :2001 PHI : 948 glavito02: 23 Median : 550000
Mean :2001 BOS : 944 bondsba01: 22 Mean : 2085656
3rd Qu.:2009 SLN : 943 griffke02: 22 3rd Qu.: 2350000
Max. :2016 BAL : 940 rodrial01: 22 Max. :33000000
(Other):20747 (Other) :26290 Ce jeu de données contient une ligne par joueur, et cinq colonnes :
yearIDpour l’année ;teamIDpour (les trois premières lettres de) l’équipe du joueur ;lgIDpour la league dans laquelle le club est engagé : “AL” (American League) ou “NL” (National League) ;playerIDest l’identifiant du joueur, pour pouvoir le retrouver d’une année sur l’autre ;salaryest le salaire annuel en dollars.
Plus exactement, nous allons comparer l’évolution des salaires des joueurs entre l’année 2007 et l’année 2016. De plus, nous allons considérer seulement trois clubs majeurs de l’American League : les Detroit Tigers (DET), Kansas City (KCA) et Oakland Athletics (OAK). Comment les salaires ont-ils évolué dans ces clubs au cours de la décennie en question ?
## Sélection des années récentes :
recent <- subset(salaries, lgID == "AL" & yearID %in% c("2007", "2016")
                 & teamID %in% c("DET", "KCA", "OAK")) |>
    mutate(yearID = as.factor(yearID)) |>
    droplevels() |>
    as_tibble()
levels(recent$yearID) <- c("Saison_2007", "Saison_2016")
summary(recent)
yearID teamID lgID playerID salary
Saison_2007:88 DET:60 AL:178 gordoal01: 2 Min. : 380000
Saison_2016:90 KCA:60 infanom01: 2 1st Qu.: 510125
OAK:58 soriajo01: 2 Median : 1662500
verlaju01: 2 Mean : 3676706
alonsyo01: 1 3rd Qu.: 5150000
alvarhe01: 1 Max. :28000000
(Other) :168 3.1.2 Estimation statistique robuste
Mise en gardeExercice : Une première représentation graphique
Comparer graphiquement les distributions des salaires des saisons 2007 et 2016, dans un premier temps avec des boxplots en parallèle.
Commentaire ?
AstuceSolution
On peut voir en Figure 3.1 que les médianes semblent “relativement proches”, mais la distribution semble ensuite s’étirer davantage vers les hauts revenus en 2016 qu’en 2007. On sent plus ou moins confusément que les boxplots ne sont peut-être pas forcément l’outil le plus adéquat pour saisir ce qui se passe ici.
boxplot(salary ~ yearID, data = recent,
        xlab = NA, ylab = "Salaire annuel (USD)")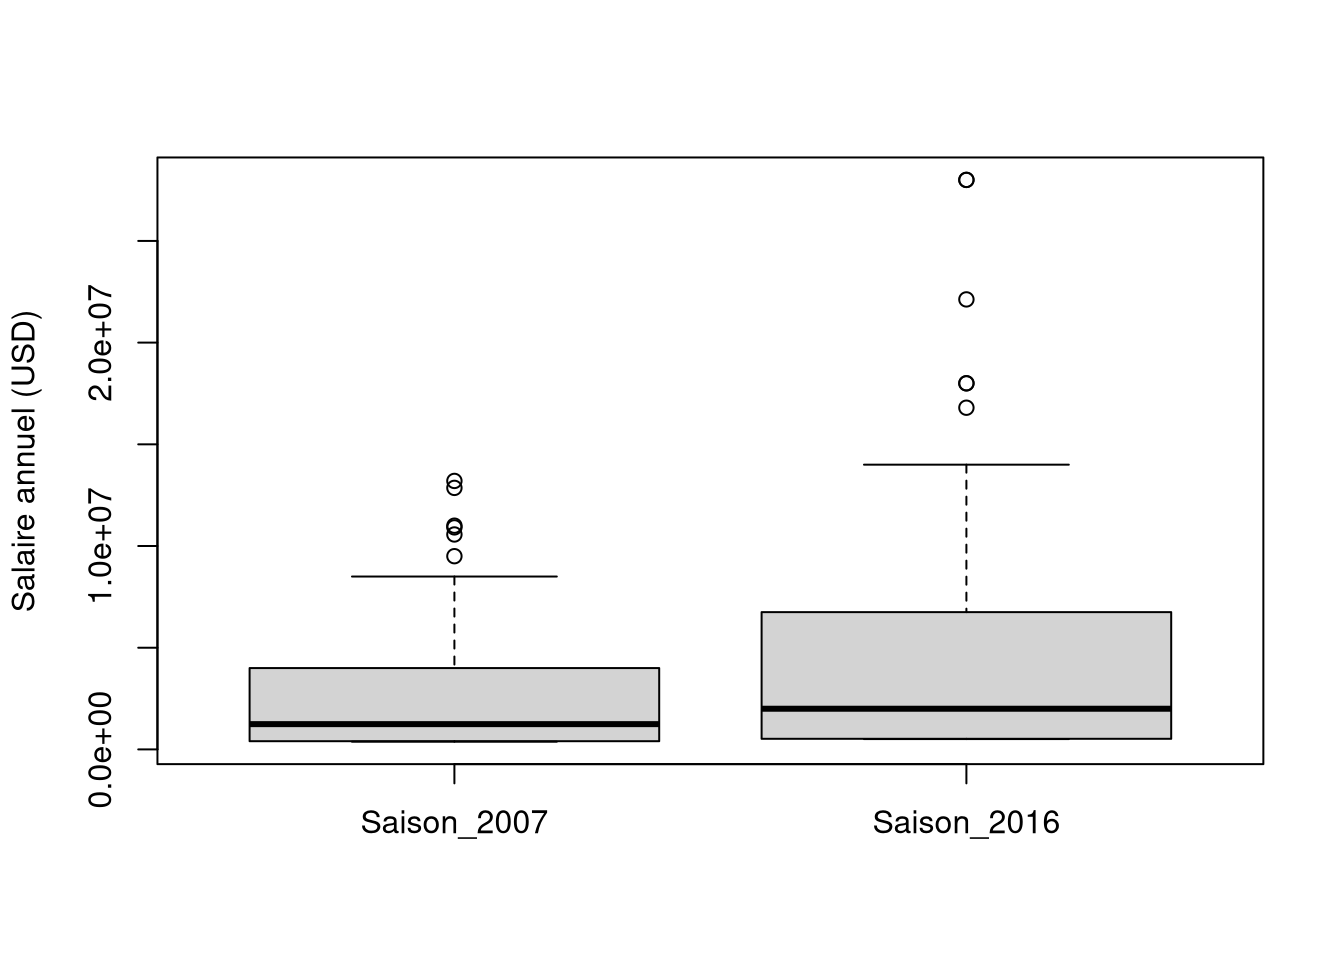
Mise en gardeExercice : Résumés statistiques robustes
Produire une table de résumés numériques pour les salaires des années 2007 et 2016, incluant : la médiane, la moyenne classique, la moyenne winsorisée (à 10%), et la moyenne tronquée ( à 10%).
AstuceSolution
Par exemple en utilisant les fonctions du Tidyverse :
recent |>
  group_by(Saison = yearID) |>
  summarise(Médiane = median(salary),
            Moyenne = mean(salary),
            Moyenne_Tronquée = mean(salary, trim = 0.1),
            Moyenne_Winsor = winsor.mean(salary, trim = 0.1))
# A tibble: 2 × 5
Saison Médiane Moyenne Moyenne_Tronquée Moyenne_Winsor
<fct> <dbl> <dbl> <dbl> <dbl>
1 Saison_2007 1243750 2741861. 2134749. 2490533.
2 Saison_2016 2000000 4590776 3333357. 3824347.3.1.3 (TODO) Tests statistiques robustes
À voir avec Julien en fonction du contenu du cours théorique. Par exemple des choses comme ceci ?
## Test de Yuen pour la comparaison des moyennes tronquées :
yuen(salary ~ yearID, data = recent, tr = 0.1)
Call:
yuen(formula = salary ~ yearID, data = recent, tr = 0.1)
Test statistic: 2.0099 (df = 126.81), p-value = 0.04656
Trimmed mean difference: -1198609
95 percent confidence interval:
-2378681 -18535.69
Explanatory measure of effect size: 0.24 3.1.4 Shift functions
Nous avons déjà vu en Section 3.1.2 (Figure 3.1) que les boxplots masquaient sans doute une partie de l’information utile pour comprendre l’évolution des salaires. En effet, la distribution des salaires est asymétrique, et relativement étirée vers la droite. Il s’agit d’une situation classique dans les distributions de salaire, mais aussi dans la distribution de temps de réponse en neurosciences, par exemple.
L’étude de ces distributions appelle des outils spécifiques. Reprenant une idée plus ancienne de Doksum et Sievers (1976), Wilcox (1995) propose de comparer (graphiquement, puis mathématiquement) les quantiles de deux distributions, lorsque la comparaison de simples moyennes (même winsorisées ou tronquées) ne semble pas apporter d’éclairage suffisant.
Mise en gardeExercice : Comparaison graphique de déciles
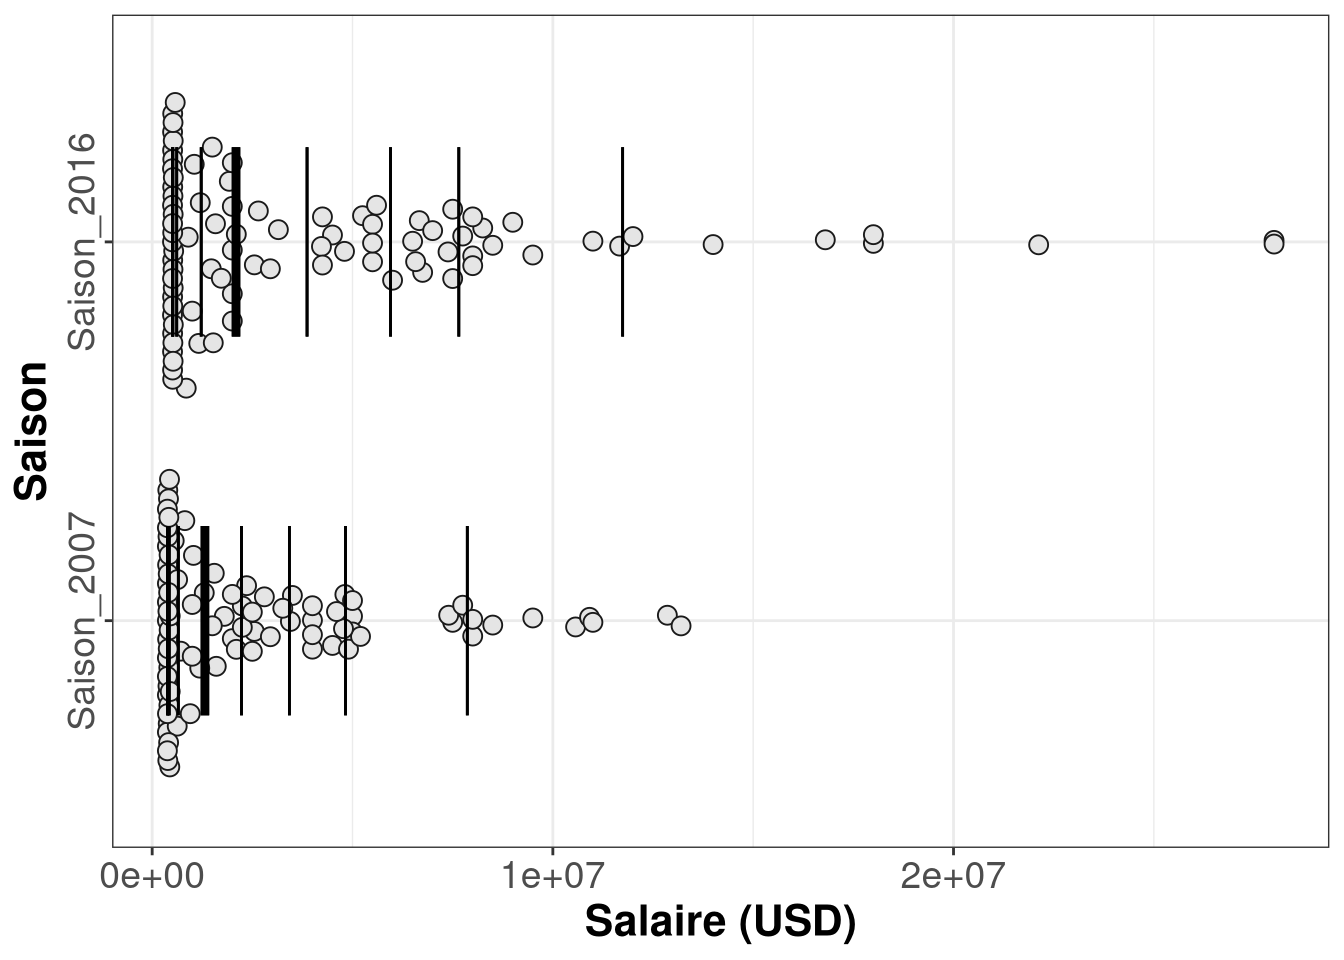
Après avoir consulté une vignette du package {rogme} pour trouver des extraits de code utiles, reproduire la Figure 3.2.
Comment interpréter ce graphique ?
AstuceSolution
Une solution possible :
## Un diagramme en bandes :
p <- plot_scat2(
  data = recent,
  formula = salary ~ yearID,
  alpha = 1,
  shape = 21,
  colour = "grey10",
  fill = "grey90",
  size = 3
) +
  theme(axis.text.y = element_text(angle = 90, hjust = .5))

## Superposer les quantiles sur le graphique précédent :
pbars <- plot_hd_bars(
  p = p,
  col = "black",
  md_size = 1.5,
) +
  labs(y = "Salaire (USD)", x = "Saison") +
  coord_flip()

## Afficher le graphique final :
pbars
Il semblerait que, sur la Figure 3.2, le début des distributions soit relativement similaire, mais que l’écart se creuse au fur et à mesure que l’on progresse dans les déciles. Autrement dit, les “bas salaires” semblent avoir relativement peu évolué entre 2007 et 2016, tandis que les “hauts salaires” semblent avoir substantiellement augmenté. Des différences de cette nature ne peuvent pas être finement capturées par une simple comparaison des moyennes ou des médianes.
Remarque. Les quantiles représentés en Figure 3.2, conformément à la suggestion de Wilcox (1995), sont calculés selon la formule de Harrell et Davis (1982).
L’idée est ensuite de pouvoir comparer ces quantiles deux à deux,pour pouvoir à quels endroits les distributions diffèrent significativement. L’approche originelle de Wilcox (1995), encore retouchée et améliorée par la suite (e.g., Wilcox et al. 2014), consistait à :
- Calculer des intervalles de confiance pour la différence entre chaque paire de quantiles (de la première et de la seconde distribution) grâce à du bootstrap.
- S’assurer que ces intervalles, dans une logique de comparaisons multiples, aient un niveau global d’erreur de type I soit égal à 5% sur l’ensemble des quantiles comparés.
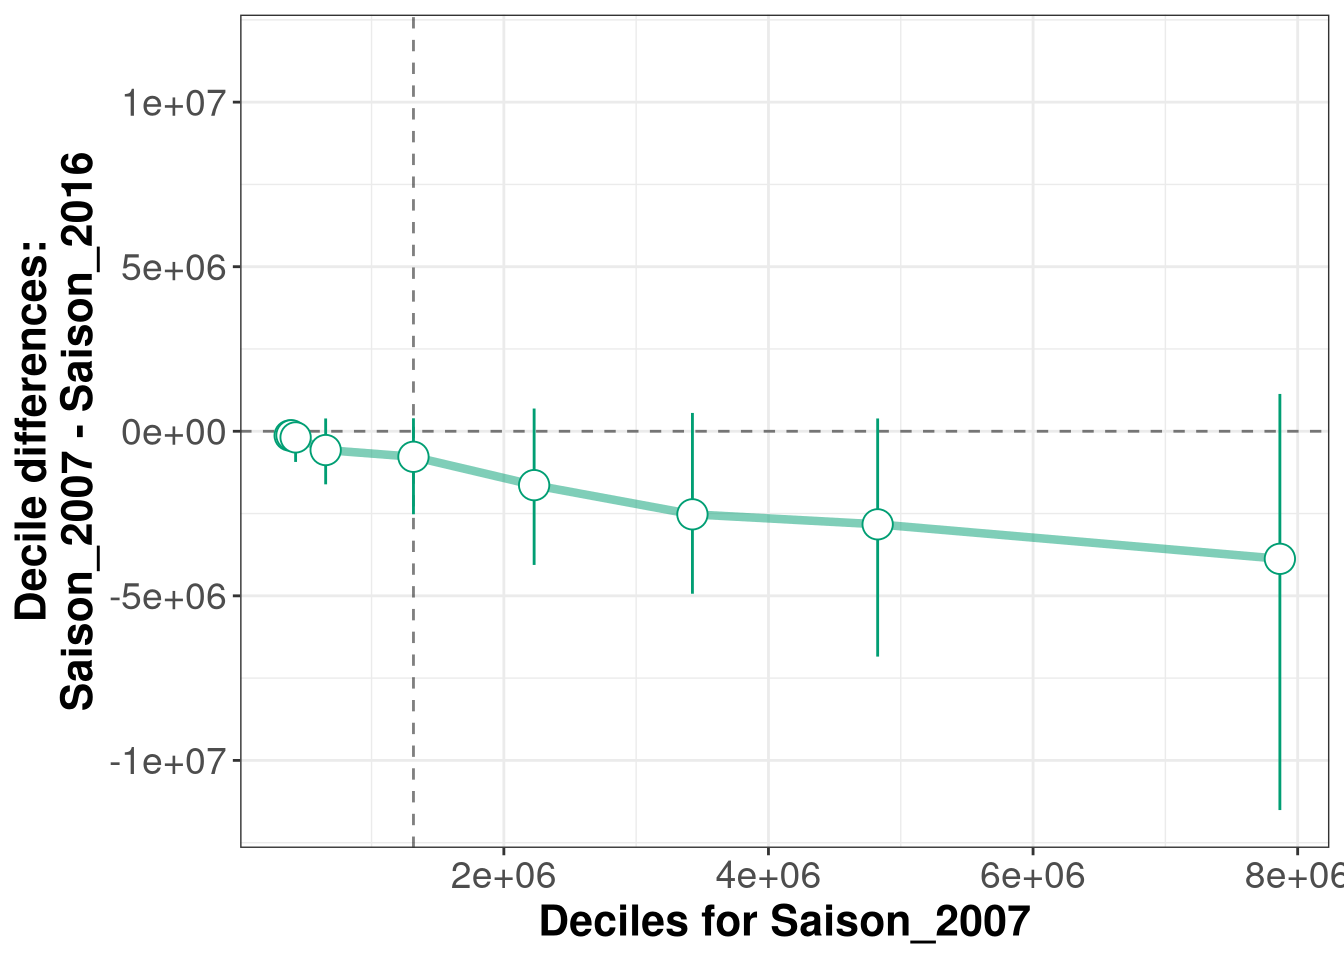
Une fois ceci fait, un bon résumé graphique est alors de représenter graphiquement la différence entre chaque paire de quantiles (avec l’intervalle de confiance associé) en fonction des quantiles de la première distribution (Doksum et Sievers 1976; Rousselet et al. 2017), comme en Figure Figure 3.3.
Mise en gardeExercice : Représenter graphiquement une shift function
Toujours en vous aidant de la documentation en ligne du package {rogme}, reproduire la Figure 3.3.
Comment interpréter cette figure, et comment conclure par rapport à notre problématique ?
AstuceSolution
On peut par exemple utiliser le code suivant :
## Calculer la shift function :
sf <- shifthd_pbci(data = recent, formula = salary ~ yearID)
## La représenter graphiquement :
plot_sf(sf)[[1]]
3.2 Exemple 2 : méthodes robustes en statistique multivariée
Dans ce deuxième exemple, nous revenons au Goldman Data Set, déjà étudié dans le chapitre précédent. Chargeons à nouveau ce jeu de données, mais en retenant cette fois des populations et des variables différentes de celles retenues jusqu’ici. Nous retenons cette fois les longueurs maximales du côté droit du corps, et étudions trois populations égyptiennes (dénommées dans ce jeu de données “Dynastic Egyptian”, “Dynastic Egyptian, El Hesa” et “Pyramiden, Gizeh”).
## Charger et nettoyer les données :
data(goldman)
egypt <- goldman |>
  select(ID, Sex, NOTE, ends_with("ML")) |>
  select(! starts_with("L")) |>
  subset(NOTE %in% c("Dynastic Egyptian", "Dynastic Egyptian, El Hesa",
                     "Pyramiden, Gizeh")) |>
  subset(Sex %in% c("F", "M")) |>
  mutate(across(where(is.character), as.factor)) |>
  rename(Population = "NOTE") |>
  mutate(Sex = fct_relevel(Sex, "F")) |>
  droplevels() |>
  textshape::column_to_rownames()
summary(egypt)
Sex Population RHML RRML
F:28 Dynastic Egyptian :17 Min. :247.0 Min. :198.5
M:46 Dynastic Egyptian, El Hesa:34 1st Qu.:292.6 1st Qu.:224.6
Pyramiden, Gizeh :23 Median :308.5 Median :239.2
Mean :306.7 Mean :237.5
3rd Qu.:323.0 3rd Qu.:248.0
Max. :354.5 Max. :285.0
NAs :8 NAs :12
RFML RTML
Min. :362.0 Min. :298.0
1st Qu.:414.4 1st Qu.:346.5
Median :430.8 Median :360.0
Mean :430.6 Mean :362.8
3rd Qu.:450.2 3rd Qu.:381.0
Max. :496.0 Max. :439.0
NAs :4 NAs :7 3.2.1 Régression linéaire robuste
Mise en gardeExercice : Nuage de points
- Créer un nouveau dataframe
hesa, qui sera le sous-ensemble du dataframeegyptcorrespondant uniquement à la Population “Dynastic Egyptian, El Hesa”. - Représenter un nuage de points croisant les variables
RFML(en ordonnées) etRTML(en abscisses) pour ce dataframehesa. Commentaire ?
Astuce
La Figure 3.4 met en évidence un très fort outlier (très probablement une erreur de saisie), ainsi que quelques bizarreries (ou non-linéarités) à gauche du graphique.
hesa <- subset(egypt, Population == "Dynastic Egyptian, El Hesa")
plot(RFML ~ RTML, data = hesa, pch = 16)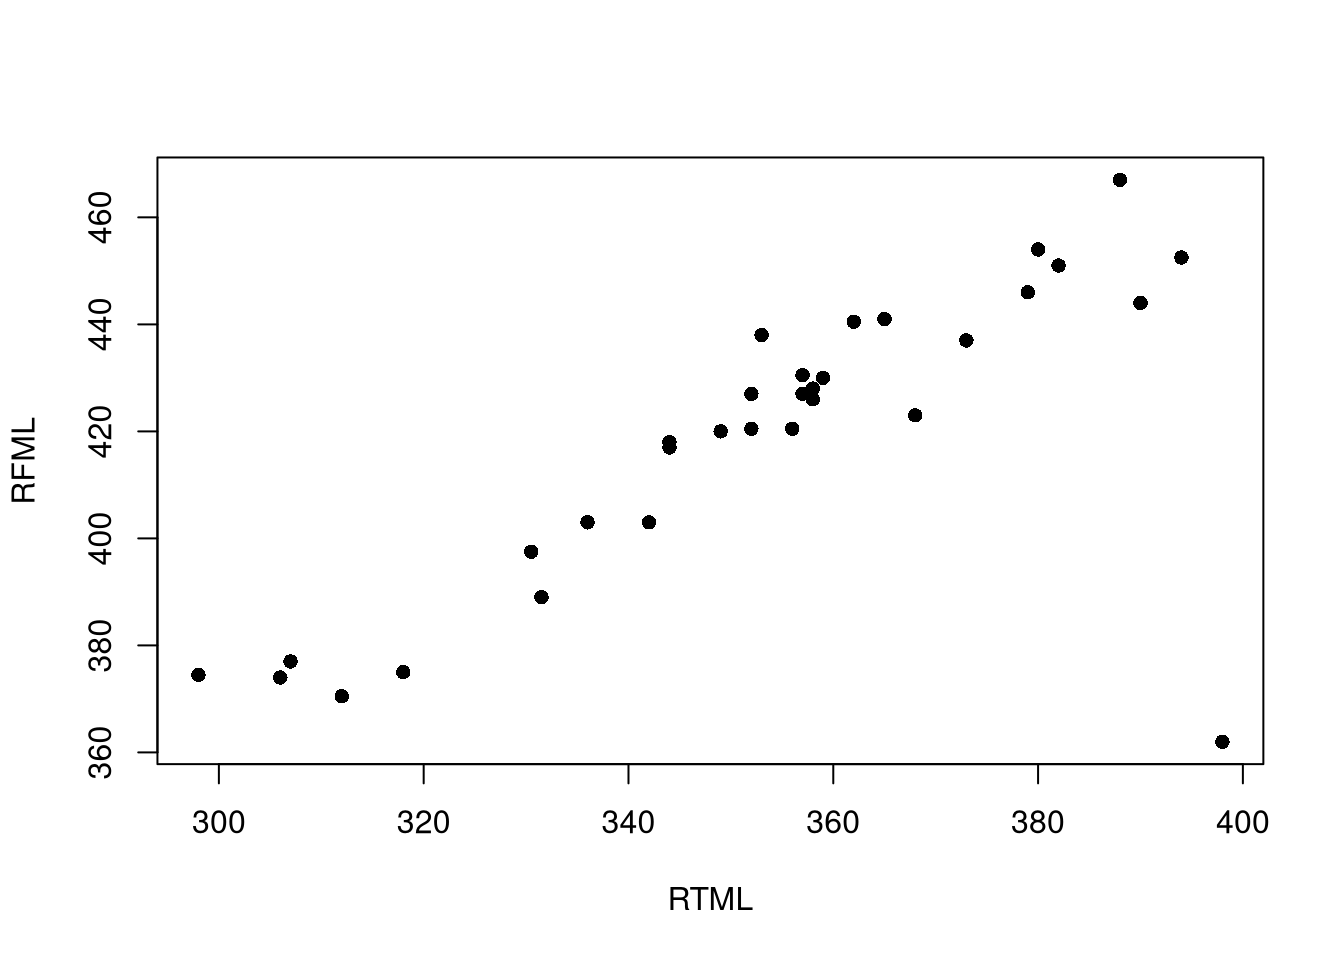
Mise en gardeExercice : Régression linéaire robuste
Sur le graphique précédent, ajouter :
- une droite de régression issue d’un modèle linéaire classique ;
- une droite de régression issue d’une méthode de régression linéaire robuste de votre choix (e.g., régression robuste implémentée dans
MASS::rlm()(Venables et Ripley 2010, 156), ou régression quantile, etc.).
Commentaire ?
Astuce
La Figure 3.5 montre clairement que la régression robuste se laisse beaucoup moins “berner” par le très fort outlier situé en bas à droite du graphique, ainsi que par les valeurs légèrement étranges à gauche du graphique. Globalement, la droite issue de la régression robuste colle beaucoup mieux à la “bonne partie des données” (non contaminée par des outliers).
## Re-tracer le nuage de points :
plot(RFML ~ RTML, data = hesa, pch = 16)

## Régression linéaire classique :
regc <- lm(RFML ~ RTML, data = hesa)
abline(regc, col = "red", lwd = 2, lty = 2)

## Régression linéaire robuste :
regr <- rlm(RFML ~ RTML, data = hesa)
abline(regr, col = "forestgreen", lwd = 2)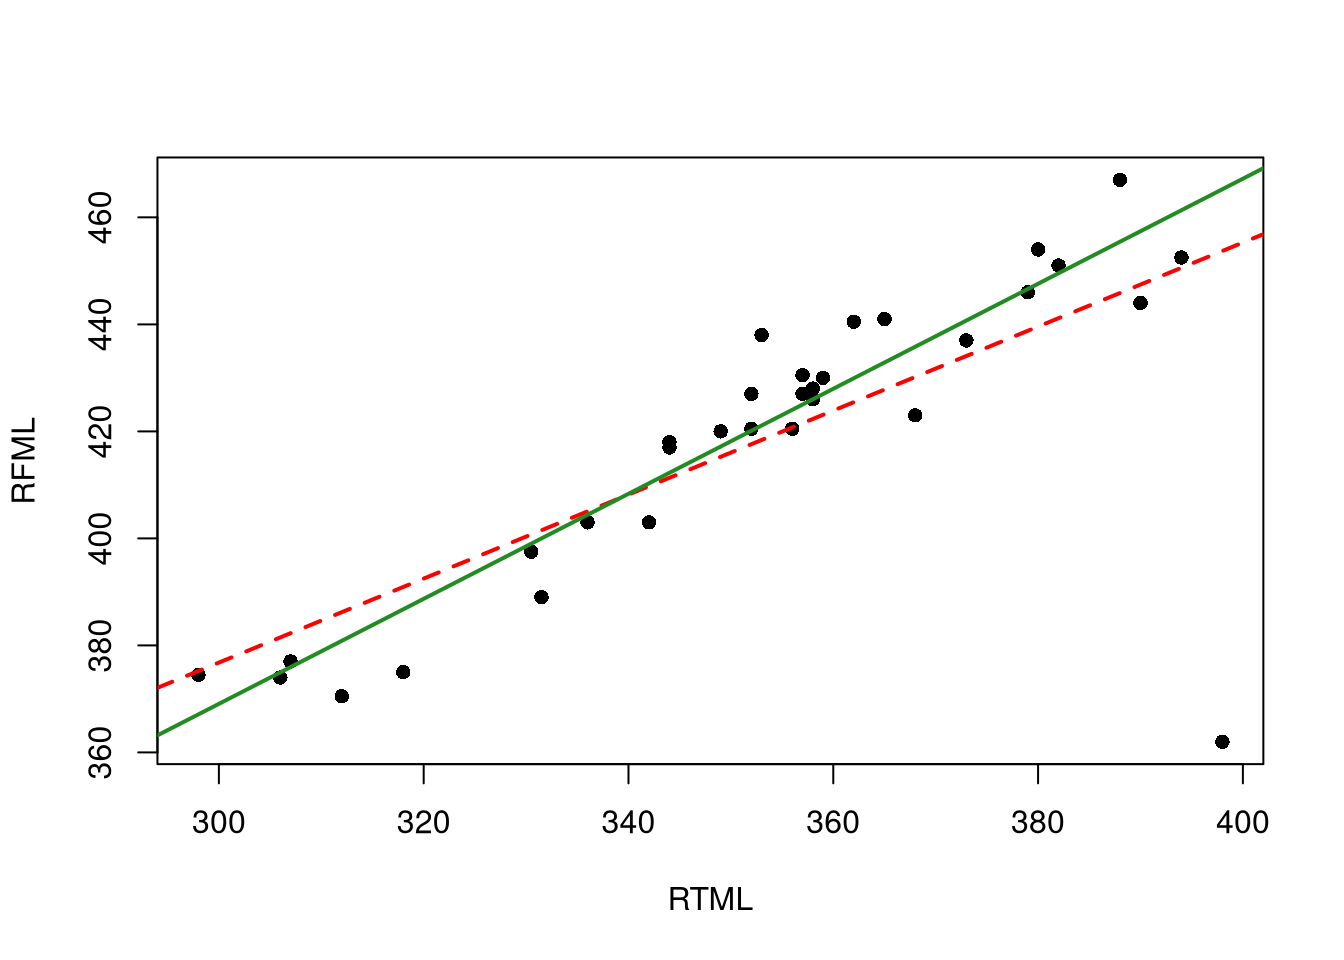
RFML en fonction de RTML.
3.2.2 Analyse linéaire discriminante robuste
Comme nous venons de le voir, il existe donc des outliers dans les données. Supposons que l’on veuille créer un modèle d’estimation du sexe à partir de ces données, c’est-à-dire utiliser les longueurs maximales des os pour prédire le sexe d’un individu. L’analyse linéaire discriminante (Fisher 1936) est un choix classique pour les méthodes d’estimation du sexe en anthropologie biologique, et cette méthode très simple fournit pourtant en général d’aussi bons résultats que des algorithmes de machine learning plus évolués (e.g., Nikita et Nikitas 2020; Santos et al. 2014).
Ici, une analyse discriminante classique pourrait être codée ainsi :
## Ne retenir que les individus complets :
egypt <- na.omit(egypt)

## Modèle d'analyse linéaire discriminante classique sur l'ensemble des variables :
mod.lda <- lda(Sex ~ RTML + RFML + RHML + RRML, data = egypt)

## Matrice de confusion obtenue en apprentissage :
table(
  Sexe = egypt$Sex,
  Prédiction = predict(mod.lda, egypt)$class
)
Prédiction
Sexe F M
F 14 5
M 2 32On voit qu’en apprentissage, le modèle commet 7 erreurs d’estimation du sexe (5 femmes prédites à tort comme des hommes, et 2 hommes prédits à tort comme des femmes).
Note
Évidemment, il faudrait aller plus loin dans la pratique, avec de la validation croisée, éventuellement un jeu de données externe pour tester le modèle sur de nouvelles données, etc. Le but n’est toutefois pas de faire un focus sur le design des études en machine learning, et nous nous contenterons donc de cette approche extrêmement basique ici.
L’analyse linéaire discriminante est toutefois basée sur des distances de Mahalanobis et des matrices de covariance “classiques”, avec les mêmes défauts et la même sensibilité aux outliers que ce qui a déjà été décrit en Section 1.3.4. Il est donc possible d’utiliser l’algorithme MCD pour effectuer cette analyse discriminante sur une version robuste de la matrice de covariance ! On parle alors d’analyse discriminante robuste, implémentée en R dans le package {rrcov} (Todorov et Filzmoser 2009).
Mise en gardeExercice : Analyse linéaire discriminante robuste
En vous inspirant du code de l’analyse linéaire discriminante classique, produire la matrice de confusion croisant le sexe réel des individus et le sexe prédit (en apprentissage, sans validation croisée) par un modèle d’analyse discriminante robuste (fonction rrcov::Linda()).
Choisir une valeur alpha adaptée pour l’algorithme MCD. Attention : la valeur par défaut est fixée à 0.5, ce qui signifie que l’algorithme ne va utiliser que les 50% de données “les plus centrales” (et donc supposer qu’on a jusqu’à 50% d’outliers dans les données). C’est beaucoup trop ici. Ramener ce paramètre à une valeur plus en adéquation avec nos observations précédentes.
Astuce
## Analyse linéaire discriminante robuste (NB : on choisit alpha = 0.9) :
mod.rob <- Linda(Sex ~ RTML + RFML + RHML + RRML, data = egypt, alpha = 0.9)

## Matrice de confusion obtenue an apprentissage :
table(
  Sexe = egypt$Sex,
  Prédiction = predict(mod.rob)@classification
)
Prédiction
Sexe F M
F 15 4
M 2 32On a donc une erreur de moins, ce qui est modeste, mais toujours bon à prendre !