library(aplpack)
library(bioanth)
library(car)
library(cellWise)
library(FactoMineR)
library(MASS)
library(OutliersO3)
library(robustbase)
library(textshape)
library(tidyverse)
library(univOutl)2 Pratique : traitement des outliers avec R
Frédéric Santos 
Commençons par charger les packages nécessaires pour ce qui suit :
2.1 Présentation du jeu de données
Le Goldman Data Set (Auerbach, s. d.; Auerbach et Ruff 2004) est un jeu de données régulièrement utilisé en anthropologie biologique : il constitue une des plus vastes collections ouvertes de données ostéométriques sur les populations du passé. En effet, il fournit un grand nombre de mesures osseuses (longueurs, diamètres et autres mesures de plusieurs os du corps humain) prises sur 1538 individus, répartis sur plusieurs continents et couvrant pratiquement tout l’holocène (c’est-à-dire les 12000 dernières années). Le Goldman Data Set est donc une ressource précieuse pour explorer la variabilité anatomique humaine à travers les époques récentes.
Le sexe et l’origine géographique des individus étant (presque toujours) renseignés, le Goldman Data Set permet en particulier de mettre en lumière les différences morphométriques en fonction de ces deux paramètres.
Parmi les variables de ce jeu de données notons que :
- la variable
NOTEcontient l’origine géographique des individus ; - la plupart des autres variables possèdent une abréviation indiquant successivement le côté (“L”/“R” pour Left/Right), l’os (“F” pour fémur, “H” pour humérus, “R” pour radius, etc.) et la mesure (“APD” pour antero-posterior diameter, “MLD” pour medio-lateral diameter, “ML” pour maximal length). Ainsi,
LRAPDindique par exemple le diamètre antéro-postérieur du radius gauche (Left Radius Antero-Posterior Diameter).
Ce jeu de données est disponible dans le package {bioanth}.
2.2 Importer et résumer le jeu de données
Vous pouvez récupérer le bloc de code ci-dessous afin d’importer le jeu de données, de le nettoyer et d’en sélectionner uniquement une petite portion (i.e., un petit nombre de variables et d’individus).
## Charger et nettoyer les données :
data(goldman)
dtf <- goldman |>
  select(ID, Sex, NOTE, ends_with("ML"), ends_with("APD")) |>
  select(! starts_with("R")) |>
  subset(NOTE %in% c("Indian Knoll", "Sayala")) |>
  subset(Sex %in% c("F", "M")) |>
  mutate(across(where(is.character), as.factor)) |>
  rename(Population = "NOTE") |>
  mutate(Sex = fct_relevel(Sex, "F")) |>
  droplevels() |>
  na.omit() |>
  textshape::column_to_rownames()
summary(dtf)
Sex Population LHML LRML LFML
F:31 Indian Knoll:46 Min. :246.0 Min. :187.0 Min. :360.0
M:37 Sayala :22 1st Qu.:294.9 1st Qu.:221.9 1st Qu.:406.4
Median :302.0 Median :235.2 Median :427.5
Mean :305.9 Mean :234.1 Mean :424.4
3rd Qu.:313.8 3rd Qu.:245.9 3rd Qu.:442.5
Max. :346.5 Max. :271.0 Max. :485.0
LTML LHAPD LRAPD LFAPD
Min. :298.0 Min. :13.57 Min. : 8.120 Min. :19.98
1st Qu.:339.4 1st Qu.:15.71 1st Qu.: 9.738 1st Qu.:23.80
Median :359.0 Median :17.02 Median :10.435 Median :25.55
Mean :356.8 Mean :17.23 Mean :10.486 Mean :25.37
3rd Qu.:373.2 3rd Qu.:18.70 3rd Qu.:11.223 3rd Qu.:27.17
Max. :417.5 Max. :22.78 Max. :12.730 Max. :29.63
LTAPD
Min. :19.74
1st Qu.:22.14
Median :24.59
Mean :24.51
3rd Qu.:26.57
Max. :30.34
NoteQue fait plus précisément le bloc de code ci-dessus ?
Si la syntaxe Tidyverse ne vous est pas familière, ce bloc de code effectue les opérations suivantes :
- sélectionner la colonne d’identifiant, le sexe, la population, ainsi que toutes les variables se terminant par “APD” (i.e., les diamètres antero-postérieurs) ou par “ML” (i.e., les longueurs maximales) ;
- parmi ces colonnes, retirer toutes celles commençant par “R” (i.e., celles correspondant à des mesures du côté droit du corps : nous ne travaillerons que sur le côté gauche) ;
- sélectionner uniquement les deux populations de Indian Knoll et Sayala ;
- sélectionner uniquement les individus de sexe connu (i.e., retirer les individus de sexe indéterminé) ;
- transformer toutes les colonnes textuelles en facteurs ;
- renommer la colonne “NOTE” en “Population” ;
- réordonner par ordre alphabétique les niveaux du facteur
Sex; - ne garder que les individus complets.
2.3 Inspection univariée
On s’intéresse dans un premier temps uniquement aux individus féminins de la population d’Indian Knoll :
## Individus féminins d'Indian Knoll :
ik <- subset(dtf, Population == "Indian Knoll" & Sex == "F")
2.3.1 Règle(s) des boxplots
Mise en gardeExercice : Détecter des outliers univariés avec le(s) règles des boxplots
Faire une boîte à moustaches pour la variable
LTMLde ce dataframeik. Existe-t-il des outliers ?Sur le graphique précédent, ajouter (à l’aide de la fonction
abline()par exemple) les limites inférieure et supérieure pour la détection d’outliers à l’aide de la règle des boxplots asymétriques. Quelle est la conclusion ?
AstuceSolution
On peut par exemple utilser le code suivant :
## Boîte à moustaches standard :
Boxplot(ik$LTML, ylab = "LTML", main = "Individus féminins d'indian Knoll",
        ylim = c(300, 380))
[1] 11 17## Ajout des limites de détection pour la règle asymétrique :
asymbox <- boxB(x = ik$LTML, k = 1.5)Warning in boxB(x = ik$LTML, k = 1.5): With method='asymmetric' (Kimber's boxplot)
the argument k is set equal to 1.5No. of outliers in left tail: 0No. of outliers in right tail: 2abline(h = asymbox$fences, col = "blue", lty = 2)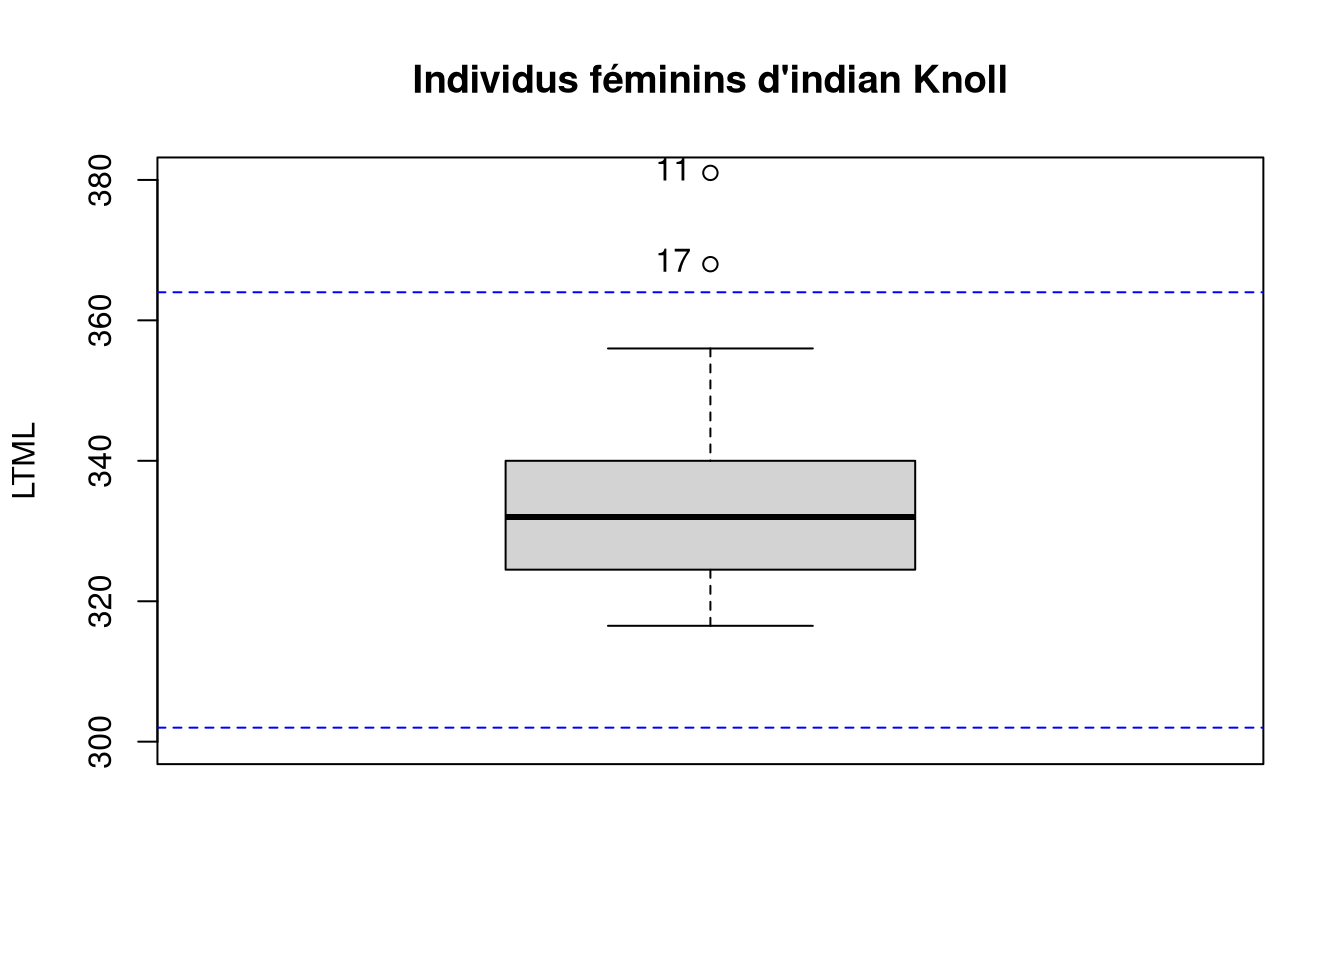
On voit ainsi que les deux outliers 11 et 17 restent des outliers même avec la règle asymétrique. C’est-à-dire que même si on pré-supposait que les longueurs de fémurs suivaient une distribution légèrement asymétrique dans cette population (on ne voit pas bien pourquoi, mais admettons, pour cet exercice !), les individus 11 et 17 seraient quand même toujours “trop grands” par rapport au reste de l’échantillon.
Dans un contexte archéologique, on peut imaginer plusieurs causes pour ces deux individus 11 et 17 : les mesures sont peut-être simplement erronées, ou bien ces deux individus n’étaient pas originaires de cette population (trace de migrations ?), ou bien l’estimation du sexe était incorrecte ici (i.e., il s’agirait en réalité de deux hommes !), ou bien il s’agit peut-être réellement de femmes très grandes, sans explication particulière.
2.3.2 Règles robustes
Mise en gardeExercice : Utiliser la MAD et l’estimateur Sn pour détecter des outliers univariés
Utiliser la méthode MAD (Mean Absolute Deviation), avec un coefficient \(k = 2\), pour détecter les outliers sur la même variable que précédemment.
Que se passe-t-il si on fait varier le coefficient, par exemple \(k \in \{2, 2.5\}\) ? Et si on change de méthode, en choisissant plutôt l’estimateur \(S_n\) plutôt que la MAD ? Utiliser par exemple la fonction
mapply()(ou la fonctionpurrr::pmap()) pour produire automatiquement les résultats correspondant à plusieurs méthodes et plusieurs seuils.
AstuceSolution
On peut commencer par utiliser la fonction LocScaleB() avec les arguments appropriés pour produire les résultats pour la méthode MAD avec un coefficient \(k = 2\) :
LocScaleB(
  x = ik$LTML,
  k = 2,
  method = "MAD",
)
No. of outliers in left tail: 0No. of outliers in right tail: 3$pars
median scale
332.0000 11.8608
$bounds
lower.low upper.up
308.2784 355.7216
$excluded
integer(0)
$outliers
[1] 10 11 17
$lowOutl
integer(0)
$upOutl
[1] 10 11 17Plutôt que de faire varier manuellement les arguments k et method, on peut utiliser un mapply() pour faire varier automatiquement ces arguments dans une gamme de valeurs donnée, et retourner les outliers détectés pour chaque combinaison d’arguments :
mapply(
  FUN = \(m, k) LocScaleB(x = ik$LTML, k = k, method = m)$outliers,
  m = c("MAD", "MAD", "Sn", "Sn"),
  k = c(2, 2.5, 2, 2.5),
  SIMPLIFY = FALSE
)
$MAD
[1] 10 11 17
$MAD
[1] 11 17
$Sn
[1] 11 17
$Sn
[1] 11 17Nous verrons plus loin, en Section 2.5, une façon plus commode de comparer les résultats de plusieurs algorithmes et/ou de plusieurs seuils.
2.4 Inspection multivariée
Nous allons cette fois nous concentrer sur l’échantillon issu du site de Sayala :
## Sélectionner uniquement l'échantillon du site de Sayala :
sayala <- subset(dtf, Population == "Sayala") |>
  select(-Population)
2.4.1 Une première inspection graphique
Simplement pour se donner une première idée informelle, on peut commencer par quelques graphiques pour voir si des points semblent prendre des valeurs inhabituelles.
Mise en gardeExercice : Réaliser une ACP
Par exemple en utilisant la fonction PCA() du package {FactoMineR} (ou toute autre fonction de votre choix !), réaliser une analyse en composantes principales du dataframe sayala, et représenter le nuage des individus. Peut-on émettre des hypothèses sur certains individus ?
AstuceSolution
On peut par exemple utiliser le code suivant :
## Calculer une ACP et stocker les résultats dans un objet R :
res.pca <- PCA(
  X = sayala,
  quali.sup = 1, # le sexe est inclus comme variable illustrative
  graph = FALSE
)
## Représenter le nuage des individus :
plot(res.pca, choix = "ind", habillage = 1)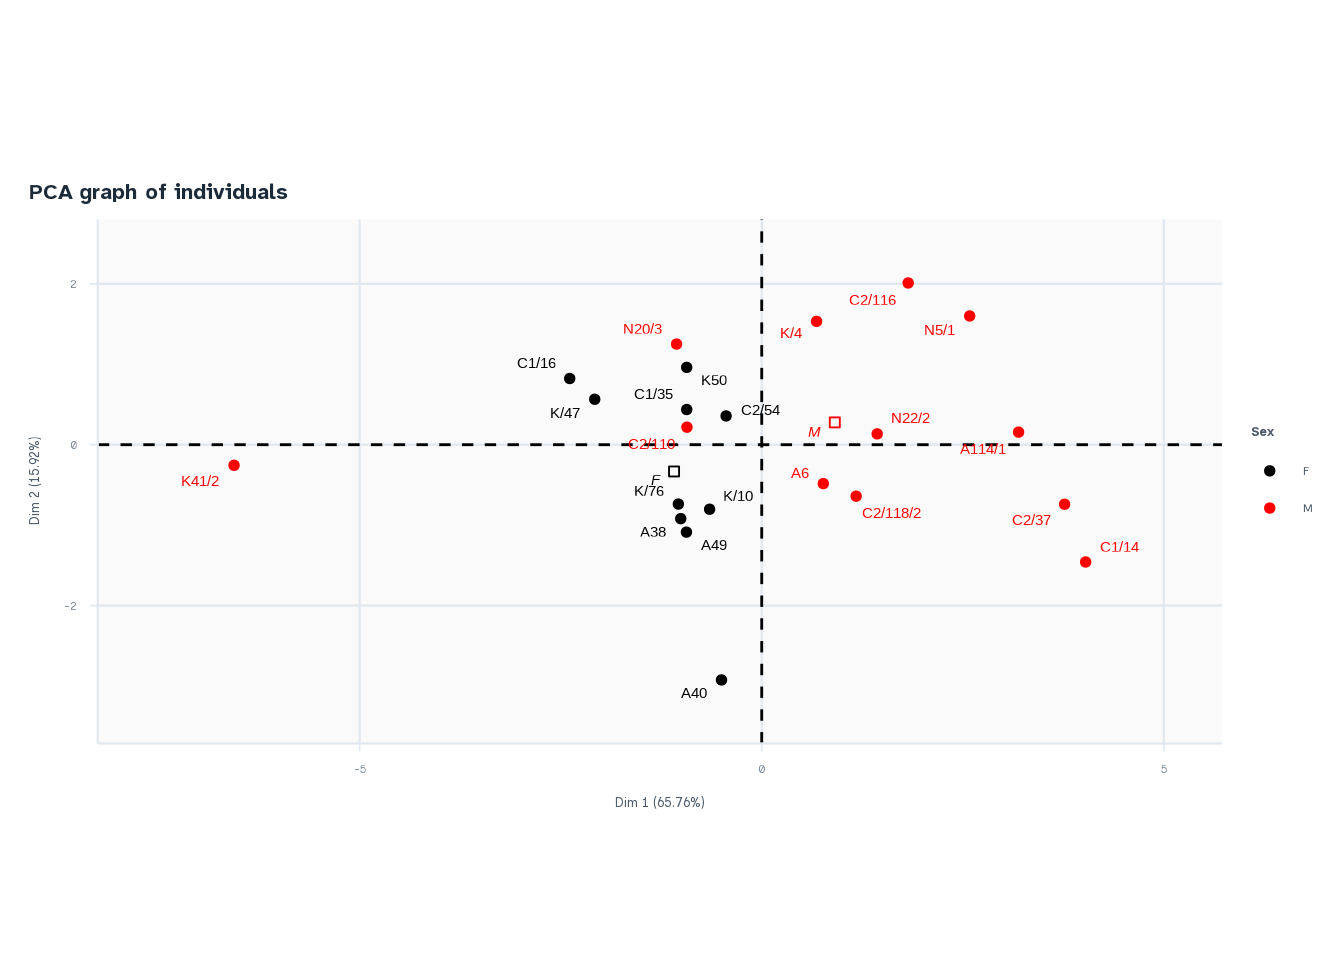
sayala.
Il semblerait que l’individu féminin K41/2 soit un fort outlier. L’individu A40 se trouve peut-être également assez loin du reste de l’échantillon.
Pour toute la suite, nous allons choisir d’ignorer le sexe des individus. Même s’il existe un clair dimorphisme sexuel, ce qui rend ce choix biologiquement problématique, nous allons volontairement l’ignorer et considérer l’échantillon de Sayala tous sexes confondus, afin de disposer d’une taille d’échantillon suffisante.
Mise en gardeExercice : Un bagplot sur les coordonnées factorielles
Reprendre les coordonnées factorielles des individus sur les deux premiers axes principaux, et représenter un bagplot sur ce nuage de points.
Combien d’outliers sont effectivement détectés ?
(Indice : si votre ACP a été réalisée avec {FactoMineR}, les coordonnées factorielles des individus se trouvent dans la composante $ind$coord du résultat de la fonction PCA().)
AstuceSolution
On peut utiliser le code suivant :
bagplot(
  x = res.pca$ind$coord[, 1],
  y = res.pca$ind$coord[, 2],
  show.center = FALSE,
  show.whiskers = FALSE,
  cex = 1
)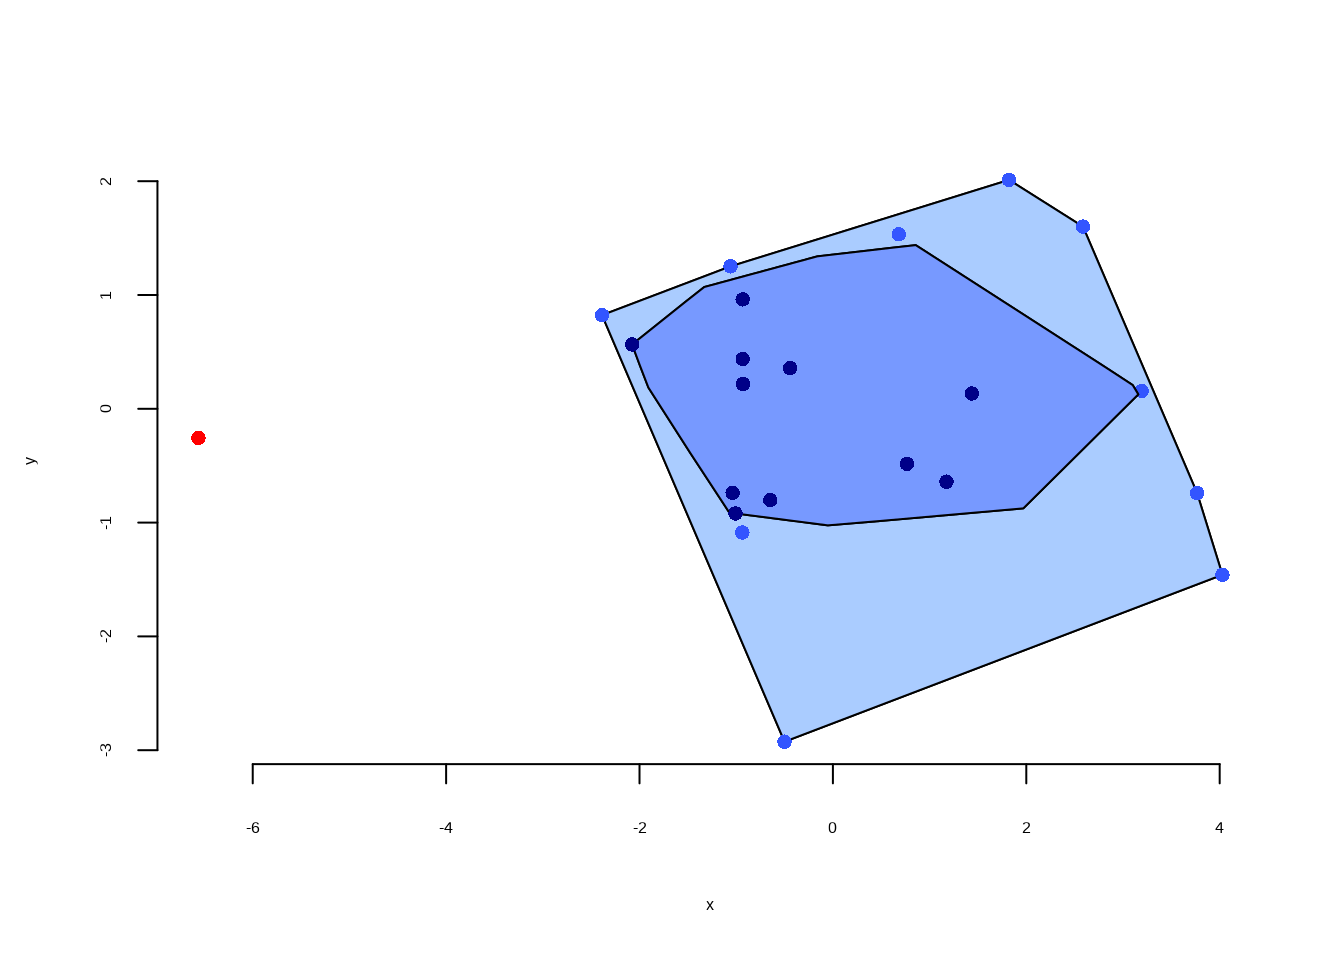
Seul l’individu K41/2 est donc détecté comme outlier ici.
2.4.2 Détection avec la méthode MCD
Mise en gardeExercice : Calcul de distances de Mahalanobis robustes
En vous inspirant du code vu en Section 1.3.4, appliquer la méthode de détection des outliers multivariés par méthode MCD. Cette fois, on utilisera la dataframe originel sayala, et non les coordonnées factorielles issues de l’ACP.
Qu’obtenez-vous ? Comment expliquer ce résultat ?
AstuceSolution
On reprend et on adapte le code donné précédemment, afin de détecter les outliers sur les données brutes du dataframe sayala :
## Calcul de la moyenne et de la covariance sur données "non contaminées" :
mcd <- covMcd(sayala[, -1], alpha = 0.9) # notez qu'on retire la colonne "Sex"

## Calcul des distances robustes à la moyenne :
d2 <- mahalanobis(
  x = sayala[, -1],                      # idem : retirer la colonne "Sex" ici
  center = mcd$center,
  cov = mcd$cov
)

## Seuil de détection :
seuil <- qchisq(0.99, df = ncol(sayala) - 1)

## Afficher les outliers :
which(d2 > seuil)
C1/35 K50
8 19 Les deux outliers détectés ne sont pas vraiment ceux qui étaient attendus au vu de nos premières explorations.
Une première limite évidente : nous n’avons ici que 22 individus, alors que nous avons 8 variables. Il s’agit d’un ratio assez défavorable pour appliquer l’algorithme MCD, qui peut parfois conduire à des résultats insatisfaisants. Pour appliquer confortablement cet algorithme, il est souhaitable d’avoir, au grand minimum, trois fois plus d’individus que de variables : ce n’est pas le cas ici.
Toutefois, nous allons voir que les résultats obtenus ne sont pas inintéressants pour autant !
2.4.3 Intermède “théorique” : forces et faiblesses de l’algorithme MCD
Vakili et Schmitt (2013) ont montré que, dans certaines configurations, l’algorthme MCD (ainsi que certains autres algorithmes dérivés de celui-ci) pouvaient aboutir à des estimations (très) incorrectes de ce que serait la matrice de covariance de la “bonne partie” (non contaminée) des données. La Figure 1 de leur article est reproduite ci-dessous :
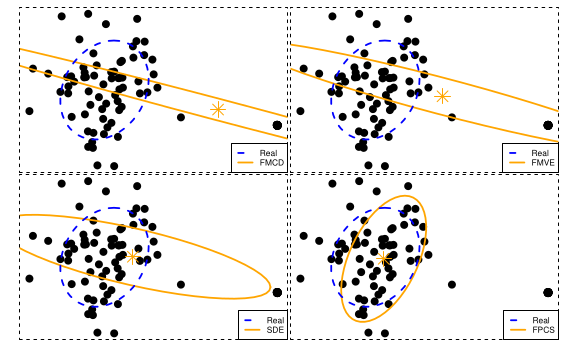
Comme l’algorithme MCD est construit de façon à minimiser la variance généralisée des données (c’est-à-dire, intuitivement, le “volume” de l’ellipse), il peut parfois être conduit, si les outliers sont disposés d’une certaine façon dans l’espace (par exemple, le long d’une direction donnée), à retenir une matrice de covariance donnant une ellipse assez “plate” le long de cet axe (et donc de faible volume). Par conséquent, les outliers ne sont pas détectés comme outliers, alors que beaucoup de “bonnes données” le sont !
Même si cela reste un cas théorique relativement rare en pratique, Vakili et Schmitt (2013) ont proposé une alternative à l’algorithme MCD, appelée FastPCS. Cet algorithme obéit à une logique très proche :
“FastPCS proceeds in two steps. First, it strives to select among many possible h-subsets of observations one devoid of outliers. Then, the outlyingness index is simply the distance of each observation to this subset.” (Vakili et Schmitt 2013)
Toutefois, il est moins sujet à des artefacts étonnants, et fournit généralement des estimateurs robustes encore plus fiables que ceux obtenus par l’algorithme MCD, comme l’illustre la Figure 2.4 ci-dessus. Ici, cela peut-il constituer un autre élément d’explication ?
Malheureusement, nous ne le saurons pas précisément ! L’algorithme FastPCS est effectivement implémenté en R, mais demande d’avoir au moins cinq fois plus d’individus que de variables pour fonctionner correctement (nous y reviendrons). Ainsi, nous ne pourrons pas l’appliquer à nos données !
Cela permet de souligner une fois de plus un fait important : pour détecter de façon réellement fiable des outliers multivariés, le ratio individus / variables est capital.
2.4.4 Renforcer notre compréhension de la situation avec les cellwise outliers
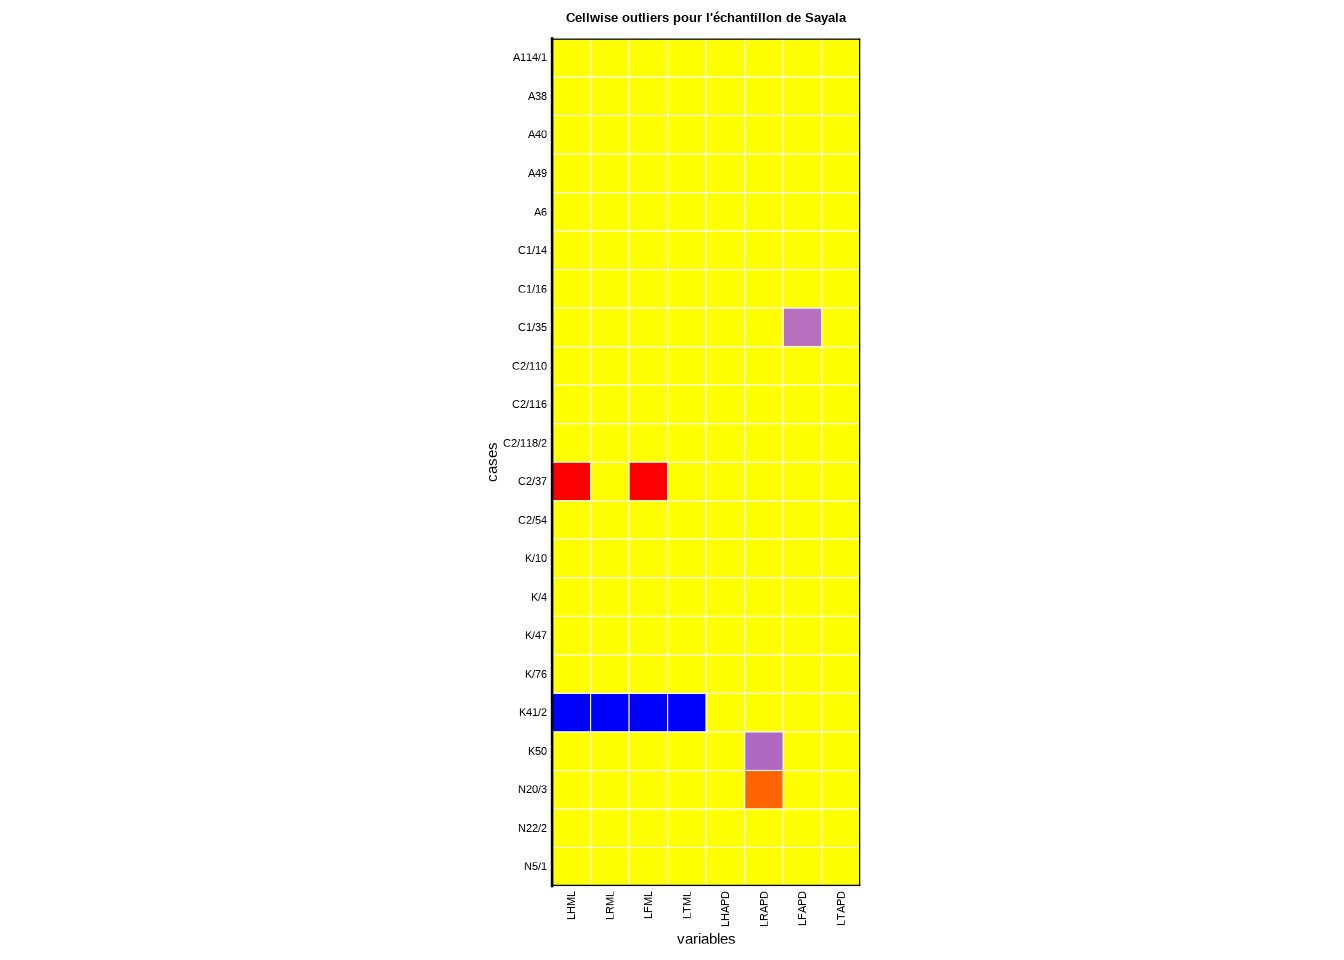
Pour tenter de comprendre exactement en quoi ces individus C1/35 et K50 seraient particuliers, l’algorithme DDC peut voler à notre secours.
Mise en gardeExercice : Détection de cellwise outliers
Appliquer l’algorithme DDC (par exemple en fixant un paramètre tolProb = 0.99), puis représenter graphiquement une carte des cellwise outliers à ce seuil de décision.
Comment ces nouvelles informations modifient-elles notre perception de la situation ?
AstuceSolution
La Figure 2.5 présente les cellwise outliers détectés dans cet échantillon. On constate que les individus K50 et C1/35 ont effectivement de légères particularités : des valeurs inhabituellement basses (au vu du reste de leur profil) pour le diamètre du radius et du fémur respectivement.
En revanche, l’outlier K41/2 qui semblait évident sur la Figure 2.2 possède bel et bien des valeurs extrêmement basses pour toutes les longueurs maximales des os étudiés (et devrait donc définitivement être détecté comme un outlier multvarié !).
## Exécuter l'algorithme DDC sur l'échantillon de Sayala :
ddc.sayala <- DDC(
  X = sayala[, -1],              # on retire ici la colonne "Sex"
  DDCpars = list(tolProb = 0.99)
)
The input data has 22 rows and 8 columns.## Carte des cellwise outliers :
cellMap(
R = ddc.sayala$stdResid,
mTitle = "Cellwise outliers pour l'échantillon de Sayala",
sizemain = 1,
sizetitles = 1.1,
sizerowlabels = 0.8,
sizecolumnlabels = 0.8
)
2.4.5 Peut-on dépasser cette apparente incohérence ?
Détecter des outliers reste généralement une tâche difficile, avec des choix subjectifs à réaliser. Si l’algorithme DDC permet souvent de trancher pour mieux comprendre les particularités de chaque “candidat outlier”, une inspection plus prudente des données en amont aurait peut-être permis de mieux comprendre certaines de ces apparentes incohérences.
Par exemple, au niveau de l’ACP, l’individu K50 sortait légèrement… mais sur les axes principaux 3 et 4, que l’on aurait pu inspecter également (Figure 2.6).
plot(res.pca, choix = "ind", habillage = 1, axes = 3:4)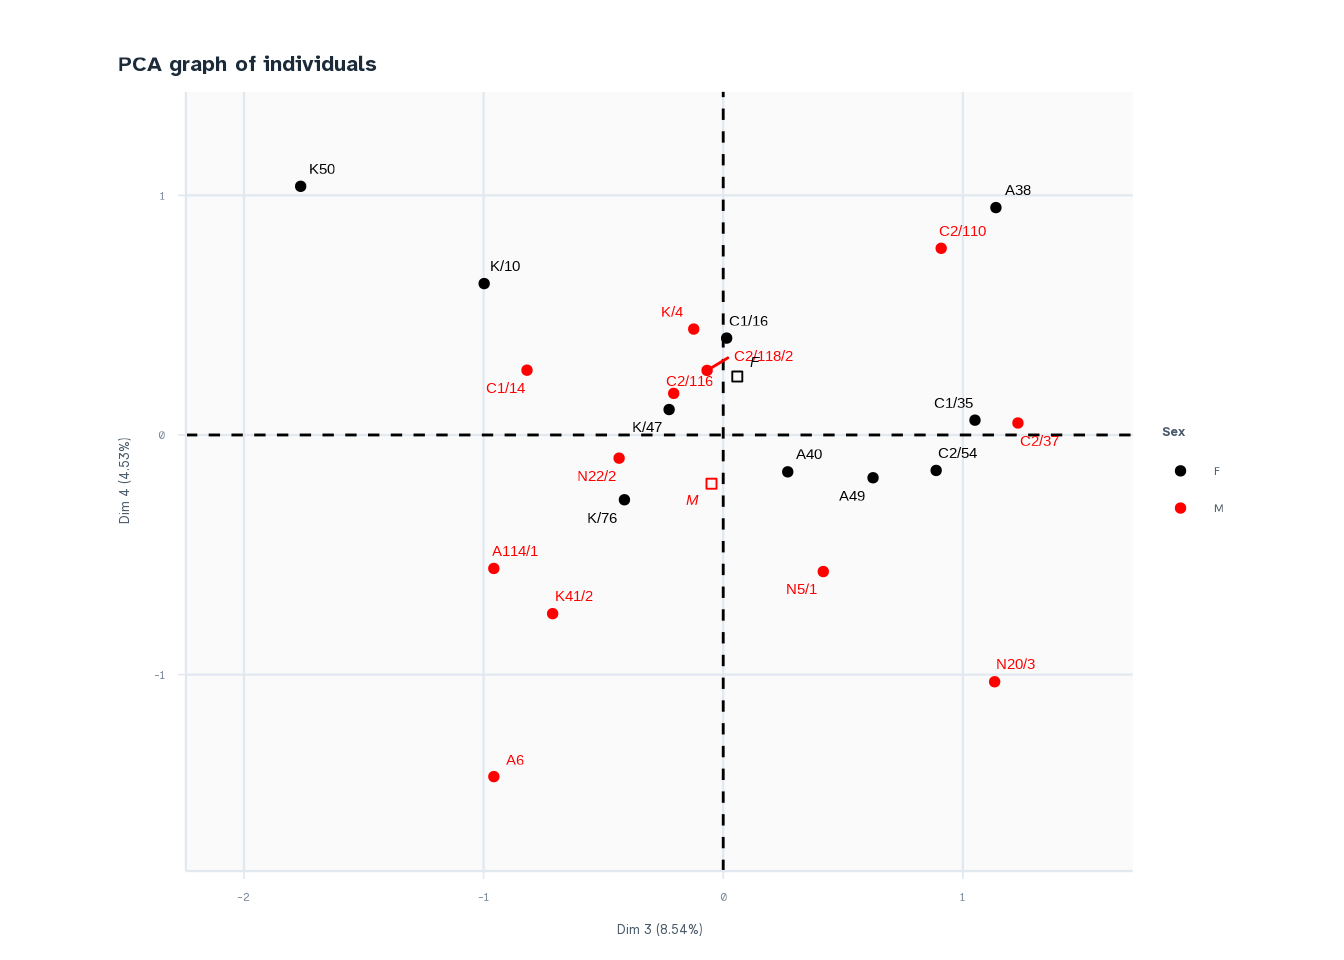
sayala (axes principaux 3 et 4).
De même, cet individu K50 aurait effectivement pu être considéré comme suspect, si on avait réalisé un parallel coordinates plot (ce qui reste lisible pour un nombre de variables inférieur à une douzaine, comme ici), comme en Figure 2.7. On peut y voir que l’individu K50 a une valeur très faible pour le diamètre du radius (LRAPD), alors que le diamètre de l’humérus est plutôt élevé. Il est anatomiquement assez peu vraisemblable qu’un individu puisse avoir un humérus très robuste et un radius très gracile : on a ici un outlier “de forme” (ni le diamètre de l’humérus, ni le diamètre du radius ne sont extrêmes en eux-mêmes, mais leur association est suspecte).
## Définir les couleurs du graphique :
couleurs <- rep("black", nrow(sayala))
couleurs[18] <- "red"  # rouge pour l'individu K41/2
couleurs[19] <- "blue" # bleu pour l'individu K50
## Parallel coordinates plot :
parcoord(sayala[, -1] , col = couleurs)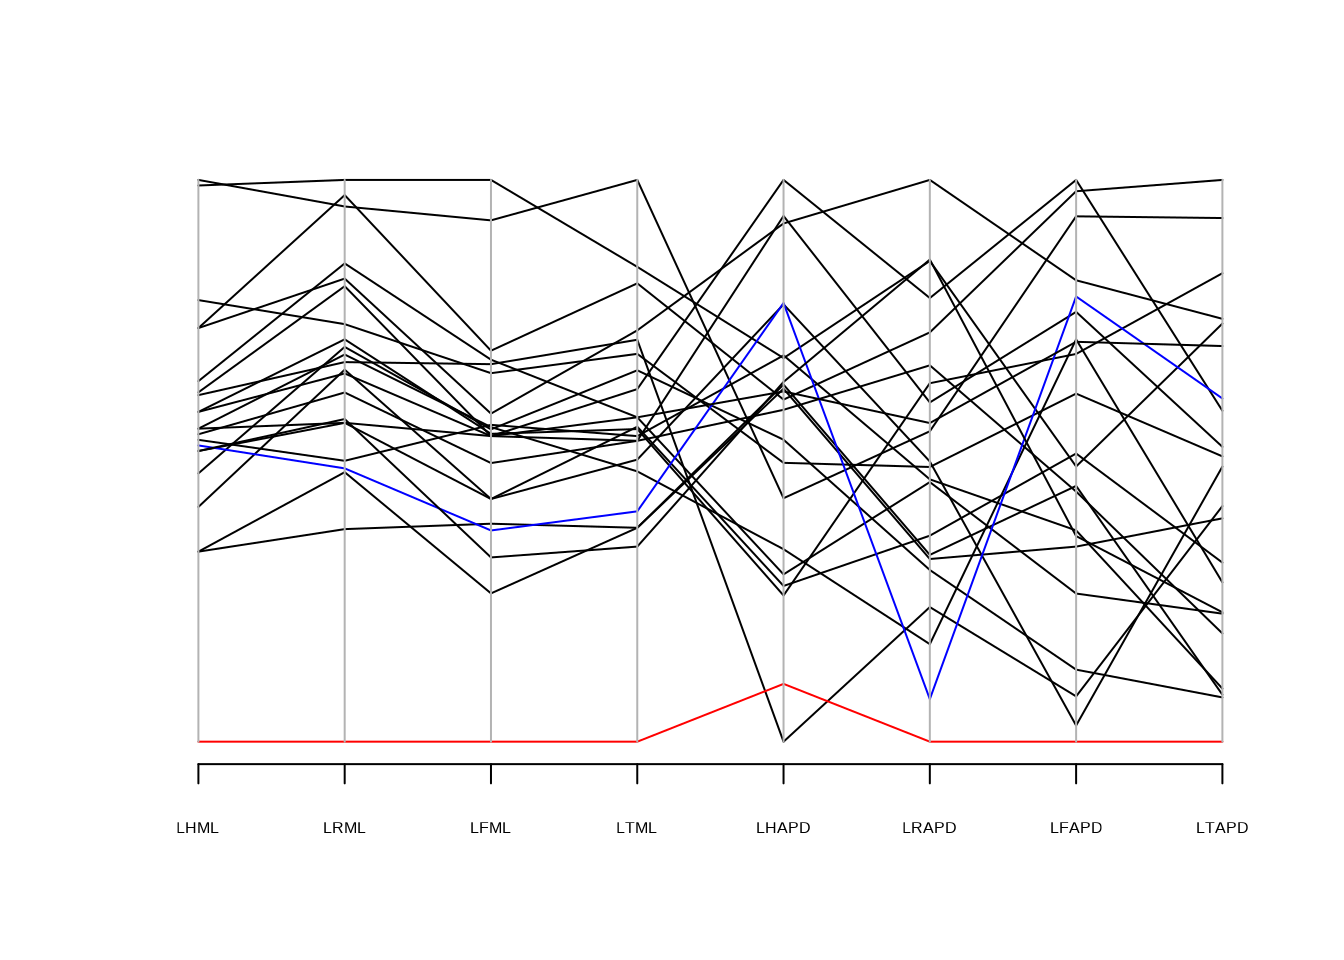
sayala. L’individu K41/2 est en rouge, et l’individu K50 est en bleu.
En revanche, il semble clair que l’individu K41/2 (en rouge) est un outlier absolu, quoi que très cohérent au niveau de la forme (il est anormalement petit pour toutes les variables).
2.5 Comparer plusieurs approches avec un O3 Plot
Comme nous avons pu le constater, différentes méthodes de détection d’outliers (univariés ou multivariés) donneront généralement différents résultats : les individus reconnus comme des outliers ne seront pas strictement les mêmes. Afin de comparer aisément les résultats de différentes méthodes, Unwin (2019) a proposé une visualisation graphique appelée O3 plot, pour “Overview Of Outliers Plot”. Ce type de graphique est disponible via le package {OutliersO3}.
Un O3 plot peut avoir différents objectifs :
- comparer les individus détectés comme outliers par un même algorithme, mais en appliquant des seuils différents (fonction
O3plotT()); - comparer les individus détectés comme outliers par des algorithmes différents, avec des seuils fixés (fonction
O3plotM()).
Mise en gardeExercice : Produire un O3 plot pour comparer deux méthodes
Réaliser un O3 plot afin de comparer les outliers de l’échantillon de Sayala détectés par la méthode “FastPCS” (pas abordée durant cette formation) et la méthode “MCD” (cf. Section 1.3.4), en fixant pour ces deux méthodes un seuil de 0.025.
Pour cela, commencer par utiliser la fonction O3prep() (consulter son aide) pour définir les paramètres généraux, et appliquer ensuite la fonction O3plotM() pour créer le graphique à proprement parler.
Plus exactement, dans la fonction O3prep(), spécifier que vous souhaitez détecter les outliers pour toutes les combinaisons de 2, 3 ou 4 variables du jeu de données sayala.
Bonus : que se passe-t-il si vous voulez tester toutes les combinaisons de 6 ou 7 variables ? Est-ce que l’erreur obtenue peut contribuer à expliquer les incohérences relevées ci-dessus ?
AstuceSolution
## Produire un O3 plot :
O3res <- O3prep(
  data = sayala[, -1],
  k1 = 2,
  K = 4,
  method = c("PCS", "MCD"),
  tolPCS = 0.025,
  tolMCD = 0.025
)
O3p <- O3plotM(O3res)
O3p$gO3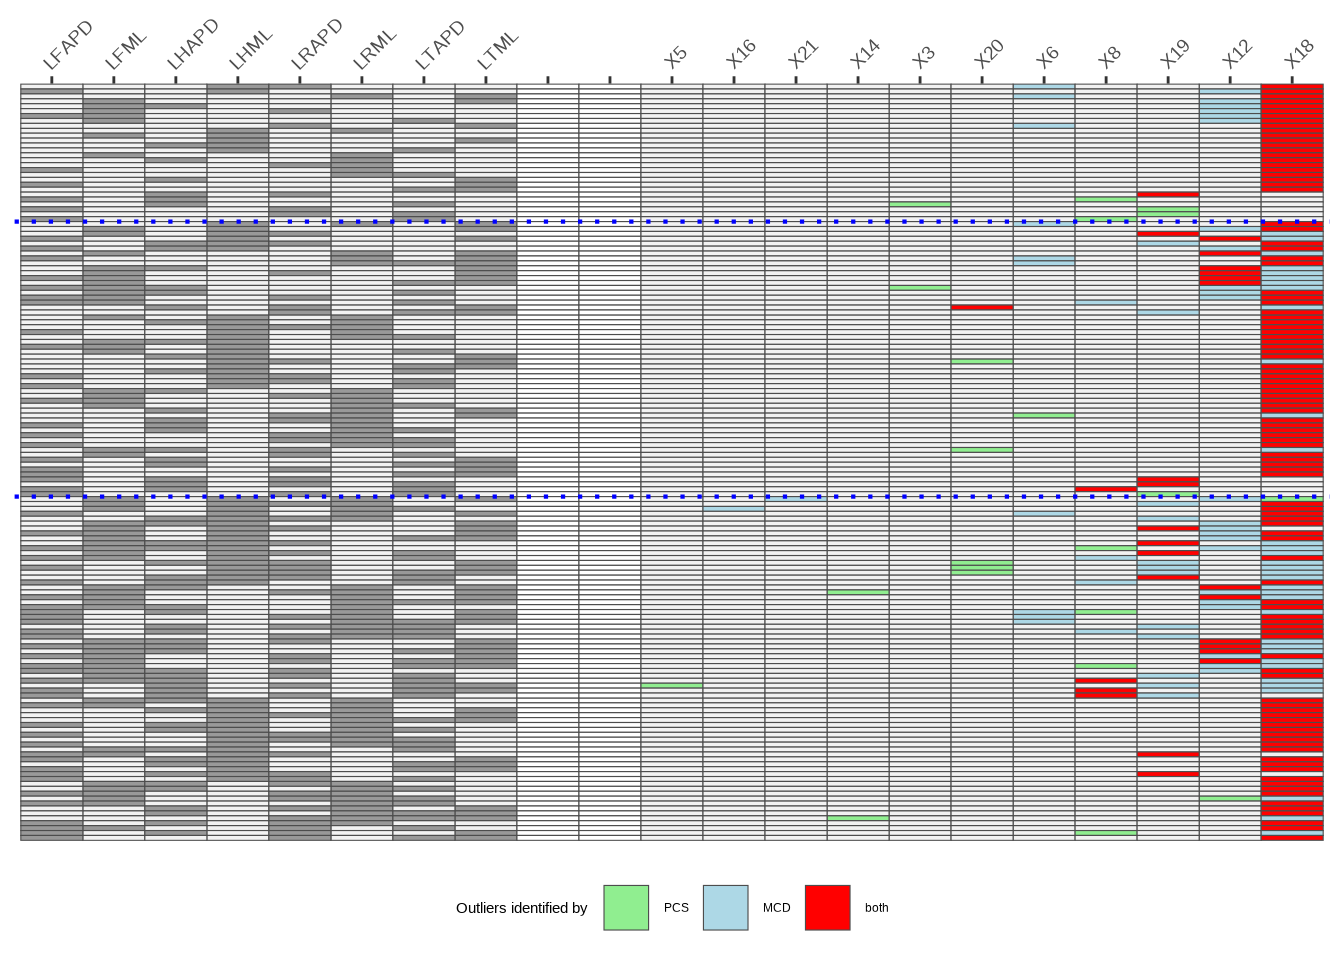
Les O3 plot n’affichent malheureusement que les numéros de ligne des individus (18, 12 et 19 ici, pour les trois outliers “principaux”), et pas le nom des individus. Pour savoir de quels individus il s’agit, on fera donc simplement :
## Récupérer le nom des trois outliers principaux :
rownames(sayala)[c(18, 12, 19)]
[1] "K41/2" "C2/37" "K50" Ainsi, en regardant toutes les combinaisons possibles de seulement deux à quatre variables, l’individu K41/2 est effectivement de très loin l’outlier le plus clair du jeu de données. Lorsque la dimension augmente encore davantage, les résultats deviennent moins fiables au vu du nombre d’individus, et même, tout simplement impossibles à calculer en ce qui concerne l’algorithme FastPCS :
## Un essai pour les combinaisons de 6 ou 7 variables :
O3res <- O3prep(
  data = sayala[, -1],
  k1 = 6,
  K = 7,
  method = c("PCS", "MCD"),
  tolPCS = 0.025,
  tolMCD = 0.025
)
Erreur dans FastPCS::FastPCS(ouF[, vars], alpha = 1 - tol) :
n<5p. You need more observations